NVIDIA表示,Vera Rubin平台的代理式推理每美元吞吐量較Blackwell Ultra最高提升30x,而每顆GPU的HBM容量只增加約3%。公司於2026年11月5日發表這項說法,認為在供應緊張、價格上升的情況下,單靠在晶片上多放記憶體並非出路。
NVIDIA提出的是「全棧協同設計」:把GPU、CPU、網絡、儲存和軟件一併設計,讓每個位元組的記憶體做更多工作。有關數字來自NVIDIA自家網誌及其引用的SemiAnalysis AgentX基準測試,屬廠商的自家說法。
為何記憶體成為AI伺服器的瓶頸?
NVIDIA指出,更大的模型、更長的上下文和代理式應用,令GPU記憶體壓力不斷上升。HBM即貼近GPU的高頻寬記憶體,是最快也最昂貴的一層,模型權重與KV cache都在爭用它。
KV cache保存模型處理每個活躍請求所需的上下文。NVIDIA稱,代理式工作會在多次模型與工具調用之間延續上下文,部分情況下處理多達3 million個token,工作記憶體因此持續膨脹。檢索增強生成(RAG)還會帶來更多上下文。
NVIDIA又提到所謂「記憶體牆」:更多HBM可容納更多用戶的上下文,但所有用戶共用同一批運算和頻寬。當頻寬供不上運算所需,多出來的容量只會閒置,卻仍增加成本和耗電。
NVIDIA怎樣應對?
NVIDIA列出三項技術,分別針對不同的浪費來源:
- 縮小權重。NVFP4格式比FP8佔用更少空間,而FP8是Hopper平台支援的最低精度。在NVL72系統內,權重最多可分散到72顆GPU,讓每顆GPU留出更多HBM給KV cache。NVIDIA列出多個以NVFP4檢查點發布的新模型,包括自家的Nemotron 3.5 Super VL。
- 縮小並移動KV cache。NVFP4可令KV cache比FP8更小。Vera CPU縮短工具調用期間的閒置時間,其大容量LPDDR記憶體經NVLink-C2C連接Rubin GPU,讓暫停的上下文有近處可待。Dynamo軟件亦可把閒置上下文移到CMX上下文記憶體儲存,NVIDIA稱其每位元成本遠低於HBM。
- 精簡檢索數據。Nemotron Retriever模型產生較小的嵌入向量,cuVS函式庫讓索引放在CPU和儲存上,知識庫完全不佔HBM。
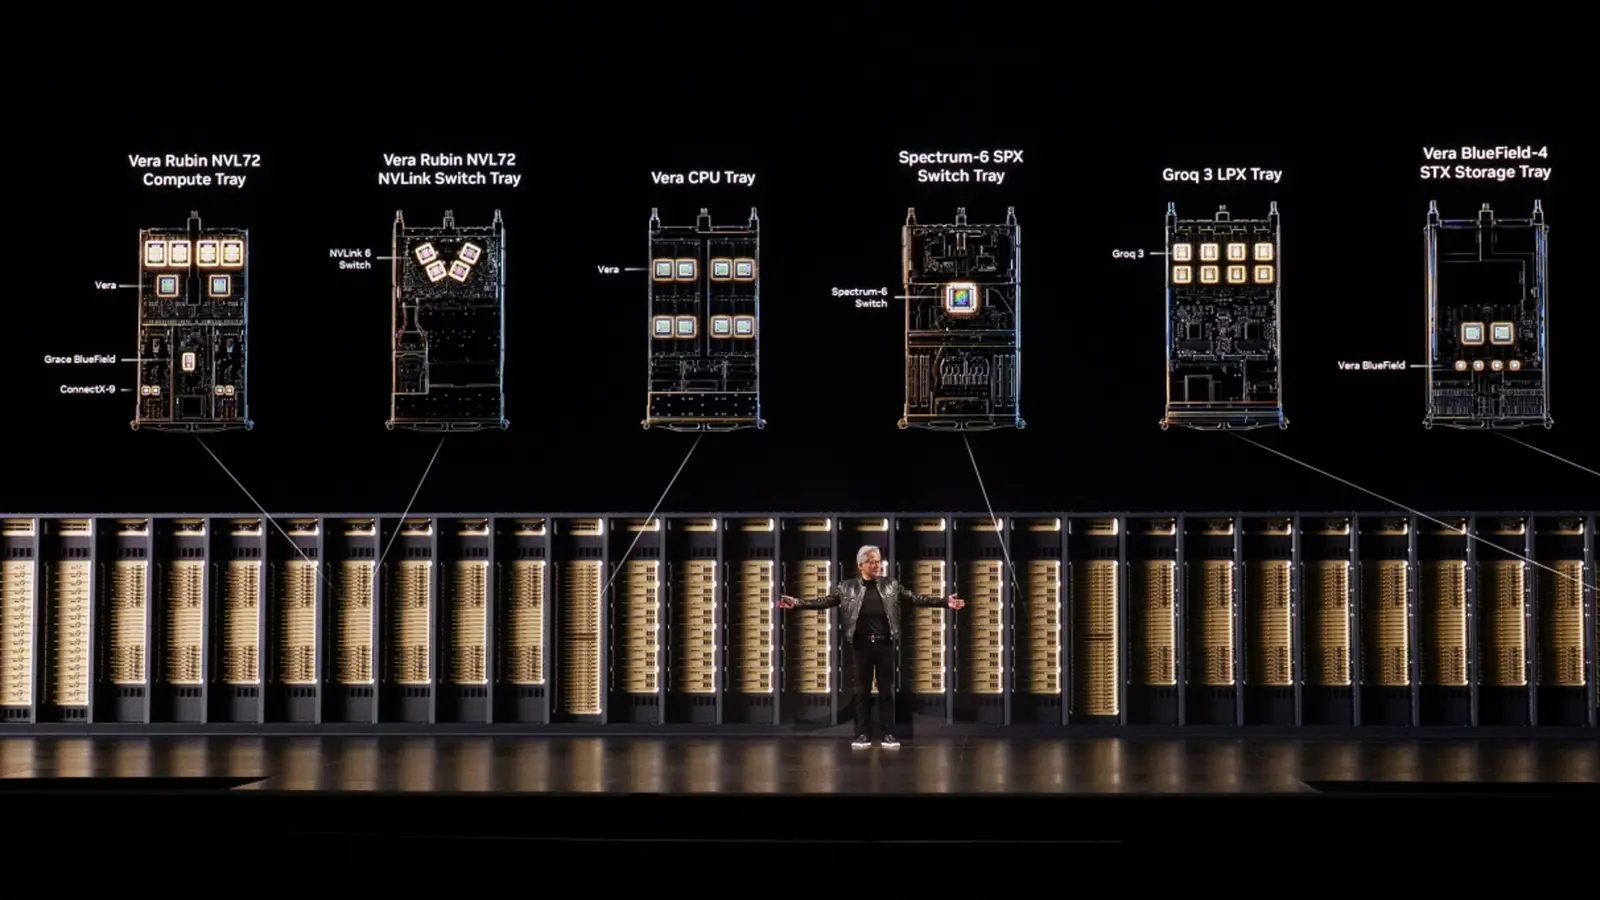
另有報道介紹NVIDIA機櫃規劃,指Vera Rubin NVL72由72顆Rubin GPU和36顆Vera CPU組成。
數字說明什麼?
NVIDIA的結果來自SemiAnalysis AgentX的DeepSeek V4 Pro工作負載:
- GB300 NVL72對H200:在每用戶每秒100個token下,每美元吞吐量最高達10x,每顆GPU的HBM容量約增一倍。
- Vera Rubin NVL72對GB300 NVL72:在每用戶每秒125個token下,每美元吞吐量最高達30x,每顆GPU的HBM容量增約3%。
NVIDIA稱,營運商最在意的是在耗電預算內、同時滿足回應時間要求下,能交付多少有用的token。公司亦表示自己是首個把HBM3e和HBM4用於加速運算平台的廠商。
價格
這篇文章沒有列出價格,也沒有Vera Rubin系統的出貨日期。文中只說記憶體供應收緊、價格上升,預計短期內持續。如需報價,請向NVIDIA或伺服器供應商查詢。
適合哪些讀者
數據中心與雲端買家。如果按token付費使用推理服務,這項說法最值得關注。每美元及每瓦吞吐量,是應要求供應商以自己工作負載確認的數字。
AI開發者。以NVFP4檢查點發布的模型,以及Dynamo、cuVS等工具,是現時可以研究的實際部分。
一般手機與電腦買家。這是機櫃級伺服器硬件,沒有直接面向消費者的產品。文中所述的記憶體緊張,正是推高價格的同一供應壓力。
應該等一等的人。打算依據這些數字採購的人,宜等獨立測試結果,因為數字由NVIDIA提供,且只基於單一測試工作負載。
仍未知的事
NVIDIA沒有說明增幅有多少來自記憶體技術、多少來自運算本身的提升,也沒有說明其他工作負載的結果。獨立測試和定價將顯示客戶實際能得到多少。
下一步:閱讀原文連結的技術深入分析和影片說明,並用自己的模型與上下文長度對照AgentX結果。