NVIDIA表示,Vera Rubin平台的代理式推理每美元吞吐量较Blackwell Ultra最高提升30x,而每颗GPU的HBM容量只增加约3%。公司于2026年11月5日发表这项说法,认为在供应紧张、价格上升的情况下,单靠在芯片上多放内存并非出路。
NVIDIA提出的是“全栈协同设计”:把GPU、CPU、网络、储存和软件一并设计,让每个位元组的内存做更多工作。有关数字来自NVIDIA自家网志及其引用的SemiAnalysis AgentX基准测试,属厂商的自家说法。
为何内存成为AI服务器的瓶颈?
NVIDIA指出,更大的模型、更长的上下文和代理式应用,令GPU内存压力不断上升。HBM即贴近GPU的高频宽内存,是最快也最昂贵的一层,模型权重与KV cache都在争用它。
KV cache保存模型处理每个活跃请求所需的上下文。NVIDIA称,代理式工作会在多次模型与工具调用之间延续上下文,部分情况下处理多达3 million个token,工作内存因此持续膨胀。检索增强生成(RAG)还会带来更多上下文。
NVIDIA又提到所谓“内存墙”:更多HBM可容纳更多用户的上下文,但所有用户共用同一批运算和频宽。当频宽供不上运算所需,多出来的容量只会闲置,却仍增加成本和耗电。
NVIDIA怎样应对?
NVIDIA列出三项技术,分别针对不同的浪费来源:
- 缩小权重。NVFP4格式比FP8占用更少空间,而FP8是Hopper平台支持的最低精度。在NVL72系统内,权重最多可分散到72颗GPU,让每颗GPU留出更多HBM给KV cache。NVIDIA列出多个以NVFP4检查点发布的新模型,包括自家的Nemotron 3.5 Super VL。
- 缩小并移动KV cache。NVFP4可令KV cache比FP8更小。Vera CPU缩短工具调用期间的闲置时间,其大容量LPDDR内存经NVLink-C2C连接Rubin GPU,让暂停的上下文有近处可待。Dynamo软件亦可把闲置上下文移到CMX上下文内存储存,NVIDIA称其每位元成本远低于HBM。
- 精简检索数据。Nemotron Retriever模型产生较小的嵌入向量,cuVS函式库让索引放在CPU和储存上,知识库完全不占HBM。
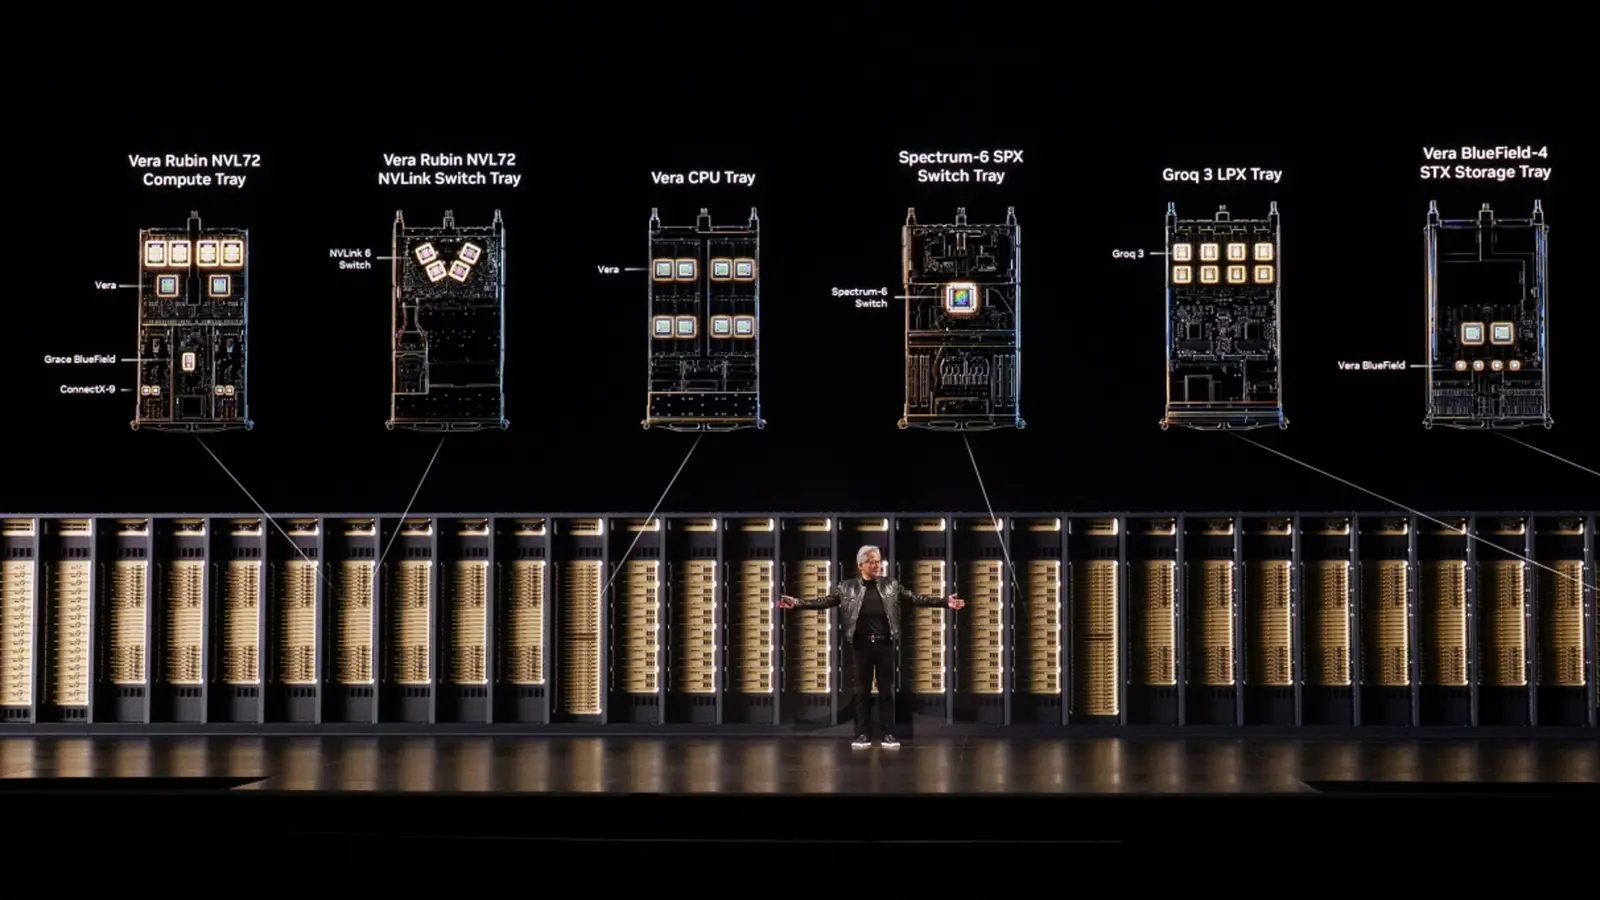
另有报道介绍NVIDIA机柜规划,指Vera Rubin NVL72由72颗Rubin GPU和36颗Vera CPU组成。
数字说明什么?
NVIDIA的结果来自SemiAnalysis AgentX的DeepSeek V4 Pro工作负载:
- GB300 NVL72对H200:在每用户每秒100个token下,每美元吞吐量最高达10x,每颗GPU的HBM容量约增一倍。
- Vera Rubin NVL72对GB300 NVL72:在每用户每秒125个token下,每美元吞吐量最高达30x,每颗GPU的HBM容量增约3%。
NVIDIA称,营运商最在意的是在耗电预算内、同时满足回应时间要求下,能交付多少有用的token。公司亦表示自己是首个把HBM3e和HBM4用于加速运算平台的厂商。
价格
这篇文章没有列出价格,也没有Vera Rubin系统的出货日期。文中只说内存供应收紧、价格上升,预计短期内持续。如需报价,请向NVIDIA或服务器供应商查询。
适合哪些读者
数据中心与云端买家。如果按token付费使用推理服务,这项说法最值得关注。每美元及每瓦吞吐量,是应要求供应商以自己工作负载确认的数字。
AI开发者。以NVFP4检查点发布的模型,以及Dynamo、cuVS等工具,是现时可以研究的实际部分。
一般手机与电脑买家。这是机柜级服务器硬件,没有直接面向消费者的产品。文中所述的内存紧张,正是推高价格的同一供应压力。
应该等一等的人。打算依据这些数字采购的人,宜等独立测试结果,因为数字由NVIDIA提供,且只基於单一测试工作负载。
仍未知的事
NVIDIA没有说明增幅有多少来自内存技术、多少来自运算本身的提升,也没有说明其他工作负载的结果。独立测试和定价将显示客户实际能得到多少。
下一步:阅读原文链接的技术深入分析和视频说明,并用自己的模型与上下文长度对照AgentX结果。