NVIDIA cho biết nền tảng Vera Rubin nâng thông lượng tác tử trên mỗi USD lên tới 30x so với Blackwell Ultra, trong khi dung lượng HBM trên mỗi GPU chỉ tăng khoảng 3%. Hãng công bố nhận định này vào ngày 5 tháng 11 năm 2026, cho rằng khi nguồn cung eo hẹp và giá tăng, nhồi thêm bộ nhớ vào chip không phải lời giải.
Thay vào đó, NVIDIA nói về thiết kế phối hợp toàn diện: GPU, CPU, mạng, lưu trữ và phần mềm được thiết kế cùng nhau để mỗi byte bộ nhớ làm được nhiều việc hơn. Các con số lấy từ blog của NVIDIA và bài kiểm tra SemiAnalysis AgentX mà hãng dẫn lại, nên cần hiểu đây là tuyên bố của nhà sản xuất.
Vì sao bộ nhớ là điểm nghẽn của máy chủ AI?
Theo NVIDIA, mô hình lớn hơn, ngữ cảnh dài hơn và ứng dụng tác tử đang tăng áp lực lên bộ nhớ GPU. HBM, loại bộ nhớ băng thông cao đặt cạnh GPU, là tầng nhanh nhất và đắt nhất, và trọng số mô hình cùng KV cache phải tranh giành nó.
KV cache lưu ngữ cảnh mà mô hình cần cho từng yêu cầu đang chạy. NVIDIA cho biết các phiên tác tử mang ngữ cảnh cũ qua nhiều lần gọi mô hình và công cụ, có trường hợp xử lý tới 3 million token, nên bộ nhớ làm việc ngày càng lớn. Truy xuất tăng cường (RAG) còn thêm nhiều ngữ cảnh nữa.
NVIDIA cũng nhắc tới giới hạn mà hãng gọi là bức tường bộ nhớ. Nhiều HBM hơn giữ được ngữ cảnh của nhiều người dùng hơn, nhưng mọi người cùng chia sẻ một nguồn tính toán và băng thông. Khi băng thông không theo kịp, dung lượng thêm vào nằm không mà vẫn tốn chi phí và điện.
NVIDIA làm gì để giải quyết?
NVIDIA nêu ba kỹ thuật, mỗi kỹ thuật nhắm vào một nguồn lãng phí:
- Thu nhỏ trọng số. Định dạng NVFP4 chiếm ít chỗ hơn FP8, mức độ chính xác thấp nhất mà nền tảng Hopper hỗ trợ. Trong hệ thống NVL72, trọng số có thể chia cho tối đa 72 GPU, nhờ đó mỗi GPU còn nhiều HBM hơn cho KV cache. NVIDIA kể tên một số mô hình mới phát hành kèm điểm kiểm tra NVFP4, gồm cả Nemotron 3.5 Super VL của chính hãng.
- Thu nhỏ và di chuyển KV cache. NVFP4 làm KV cache nhỏ hơn so với FP8. CPU Vera rút ngắn thời gian chờ khi gọi công cụ, còn bộ nhớ LPDDR lớn của nó, nối với GPU Rubin qua NVLink-C2C, cho ngữ cảnh tạm dừng một chỗ chờ gần đó. Phần mềm Dynamo cũng có thể chuyển ngữ cảnh nhàn rỗi sang lưu trữ bộ nhớ ngữ cảnh CMX, tầng mà NVIDIA nói rẻ hơn HBM nhiều trên mỗi bit.
- Dữ liệu truy xuất gọn hơn. Các mô hình Nemotron Retriever tạo vector nhúng nhỏ hơn, và thư viện cuVS cho phép đặt chỉ mục trên CPU và lưu trữ, nên cơ sở tri thức không bao giờ chiếm HBM.
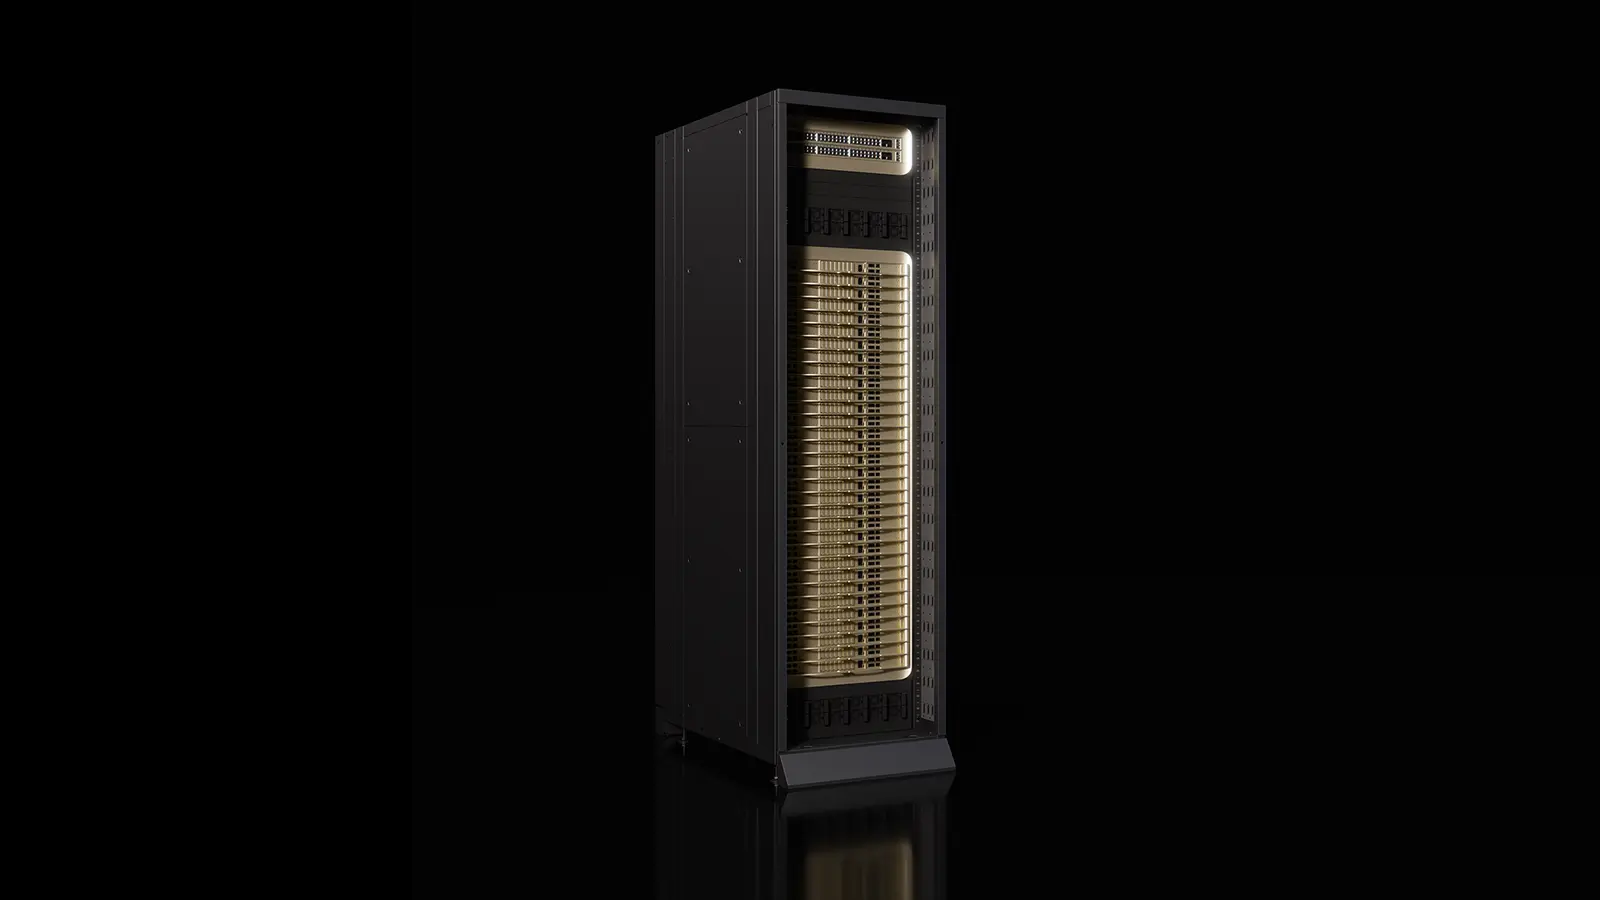
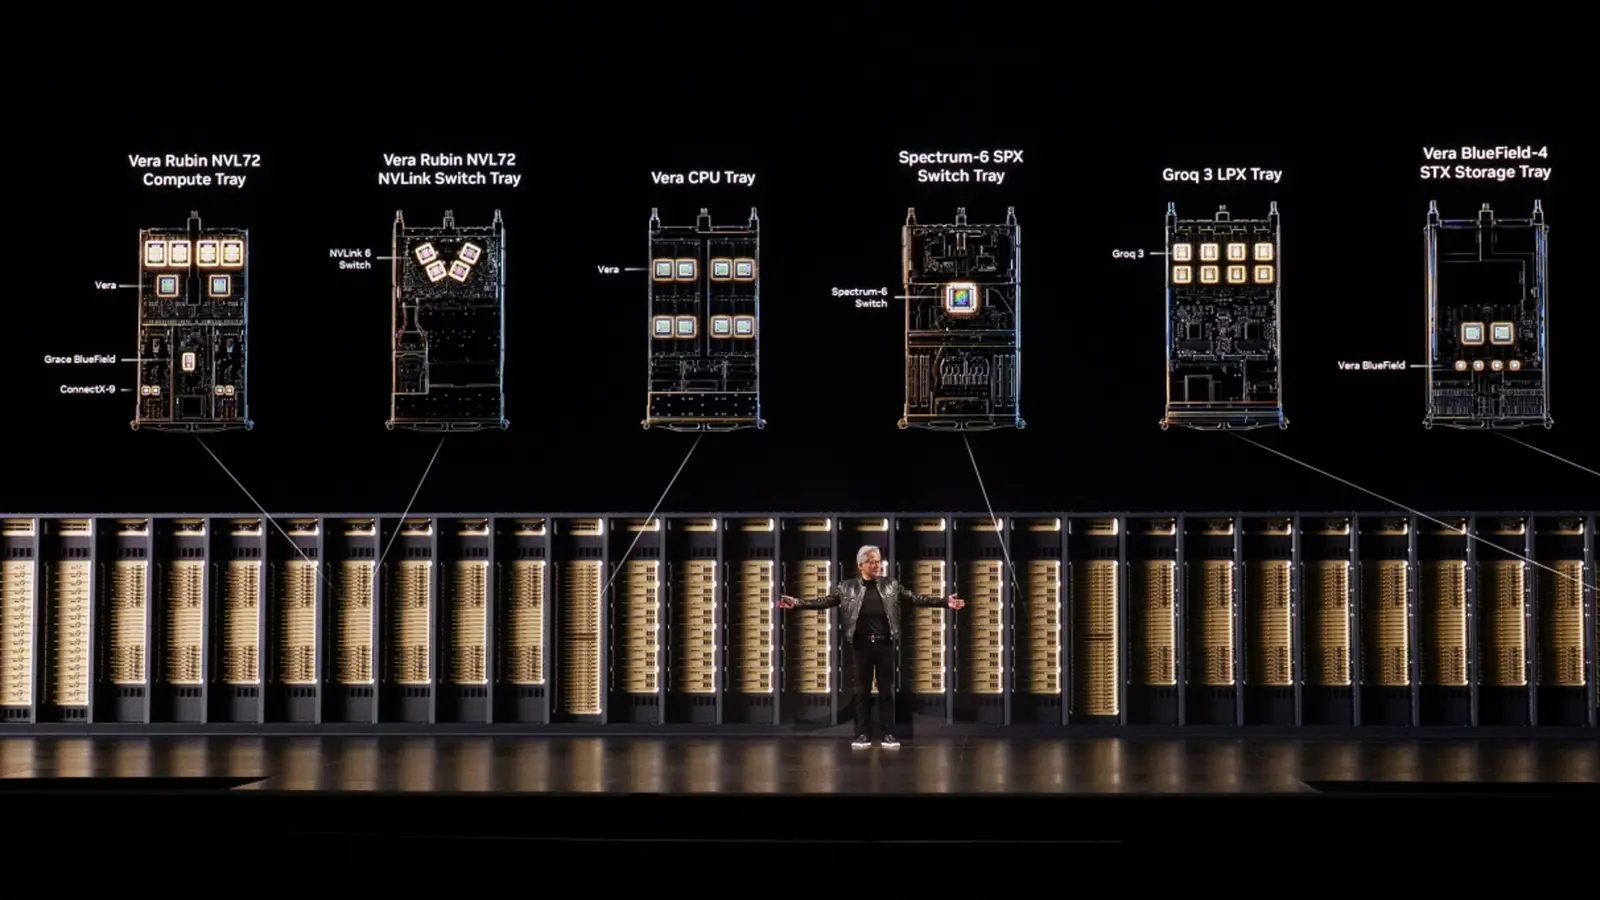
Để tham khảo, một báo cáo khác về kế hoạch giá đỡ của NVIDIA mô tả Vera Rubin NVL72 gồm 72 GPU Rubin và 36 CPU Vera.
Các con số nói gì?
Kết quả của NVIDIA đến từ khối lượng công việc DeepSeek V4 Pro của SemiAnalysis AgentX:
- GB300 NVL72 so với H200: thông lượng trên mỗi USD cao hơn tới 10x ở mức 100 token mỗi giây cho mỗi người dùng, dung lượng HBM mỗi GPU xấp xỉ gấp đôi.
- Vera Rubin NVL72 so với GB300 NVL72: thông lượng trên mỗi USD cao hơn tới 30x ở mức 125 token mỗi giây cho mỗi người dùng, dung lượng HBM mỗi GPU tăng khoảng 3%.
NVIDIA nói chỉ số mà nhà vận hành quan tâm là số token hữu ích giao được trong giới hạn điện năng mà vẫn đáp ứng thời gian phản hồi. Hãng cũng cho biết mình là bên đầu tiên đưa HBM3e và HBM4 vào một nền tảng điện toán tăng tốc.
Giá
NVIDIA không nêu giá trong bài này, cũng không có ngày giao hàng cho hệ thống Vera Rubin. Bài chỉ nói nguồn cung bộ nhớ đang thắt chặt và giá tăng, xu hướng được dự báo tiếp diễn trong ngắn hạn. Muốn báo giá, hãy hỏi NVIDIA hoặc nhà cung cấp máy chủ của bạn.
Dành cho ai
Trung tâm dữ liệu và điện toán đám mây. Tuyên bố này quan trọng nhất nếu bạn trả tiền suy luận theo token. Thông lượng trên mỗi USD và mỗi watt là các số nên yêu cầu nhà cung cấp xác nhận trên khối lượng công việc của bạn.
Nhà phát triển AI. Các mô hình có điểm kiểm tra NVFP4 và công cụ như Dynamo, cuVS là phần thực tế có thể xem xét ngay hôm nay.
Người mua máy tính và điện thoại thông thường. Đây là phần cứng máy chủ cỡ giá đỡ, không có sản phẩm trực tiếp cho người tiêu dùng. Sự thiếu hụt bộ nhớ được mô tả chính là áp lực nguồn cung mà bài viết nói đang đẩy giá lên.
Ai nên chờ. Ai định mua dựa trên các con số này nên chờ kiểm tra độc lập, vì số liệu do NVIDIA đưa ra và dựa trên một khối lượng công việc thử nghiệm duy nhất.
Điều còn chưa rõ
NVIDIA không nói mức cải thiện chia thế nào giữa các kỹ thuật bộ nhớ và sức mạnh tính toán thuần túy, cũng không nói kết quả trên các khối lượng công việc khác. Các bài kiểm tra độc lập và giá sẽ cho thấy khách hàng nhận được bao nhiêu.
Bước tiếp theo: đọc phần phân tích kỹ thuật và video giải thích được liên kết trong bài gốc, rồi so sánh kết quả AgentX với mô hình và độ dài ngữ cảnh của riêng bạn.