NVIDIAは、Vera Rubinプラットフォームのエージェント向け処理量がBlackwell Ultra比でドル当たり最大30x向上する一方、GPU当たりのHBM容量は約3%しか増えないと主張した。同社は2026年11月5日にこの内容を公表し、供給が逼迫し価格が上昇する中で、チップにメモリを積み増すだけでは解決にならないとしている。
NVIDIAが挙げるのは「フルスタック協調設計」だ。GPU、CPU、ネットワーク、ストレージ、ソフトウェアを一体で設計し、メモリの1バイトごとにより多くの仕事をさせるという考え方である。数字はNVIDIA自身のブログと、同社が引用するSemiAnalysis AgentXのベンチマークに基づくため、メーカー側の主張として読む必要がある。
なぜメモリがAIサーバーの制約になるのか
NVIDIAによると、モデルの大型化、コンテキストの長期化、エージェント型アプリの増加がGPUメモリへの負荷を高めている。GPUの隣にある高帯域メモリのHBMは最速かつ最も高価な層で、モデルの重みとKVキャッシュがその容量を奪い合う。
KVキャッシュは、各リクエストの処理に必要な文脈を保持する。NVIDIAは、エージェントの作業ではモデルやツールの呼び出しをまたいで過去の文脈が引き継がれ、場合によっては最大3 million個のトークンを処理すると説明する。作業用メモリは増え続ける。検索拡張生成(RAG)がさらに文脈を足す。
NVIDIAは「メモリの壁」という限界にも触れた。HBMを増やせばより多くの利用者の文脈を保持できるが、全員が同じ演算能力と帯域を共有する。帯域が演算に追いつかなくなると、増設した容量は使われないまま、コストと電力だけが増える。
NVIDIAは何をしているのか
NVIDIAは、無駄の原因ごとに三つの手法を挙げる。
- 重みを小さくする。NVFP4形式はFP8より必要な容量が少ない。FP8はHopperが対応する最低精度だ。NVL72システムでは重みを最大72基のGPUに分散でき、各GPUのHBMをKVキャッシュに回せる。NVIDIAは、自社のNemotron 3.5 Super VLを含む複数の新モデルがNVFP4のチェックポイントで公開されたと紹介する。
- KVキャッシュを小さくして移す。NVFP4によりKVキャッシュはFP8より小さくなる。Vera CPUはツール呼び出し中の待ち時間を縮め、NVLink-C2CでRubin GPUとつながる大容量LPDDRメモリが、一時停止した文脈の待機場所になる。Dynamoソフトウェアは、使われていない文脈をCMXコンテキストメモリストレージへ移せる。NVIDIAは、この層のビット当たりコストがHBMよりはるかに低いと述べる。
- 検索データを軽くする。Nemotron Retrieverモデルはより小さな埋め込みを作り、cuVSライブラリによってインデックスをCPUとストレージに置ける。知識ベースはHBMを一切使わない。
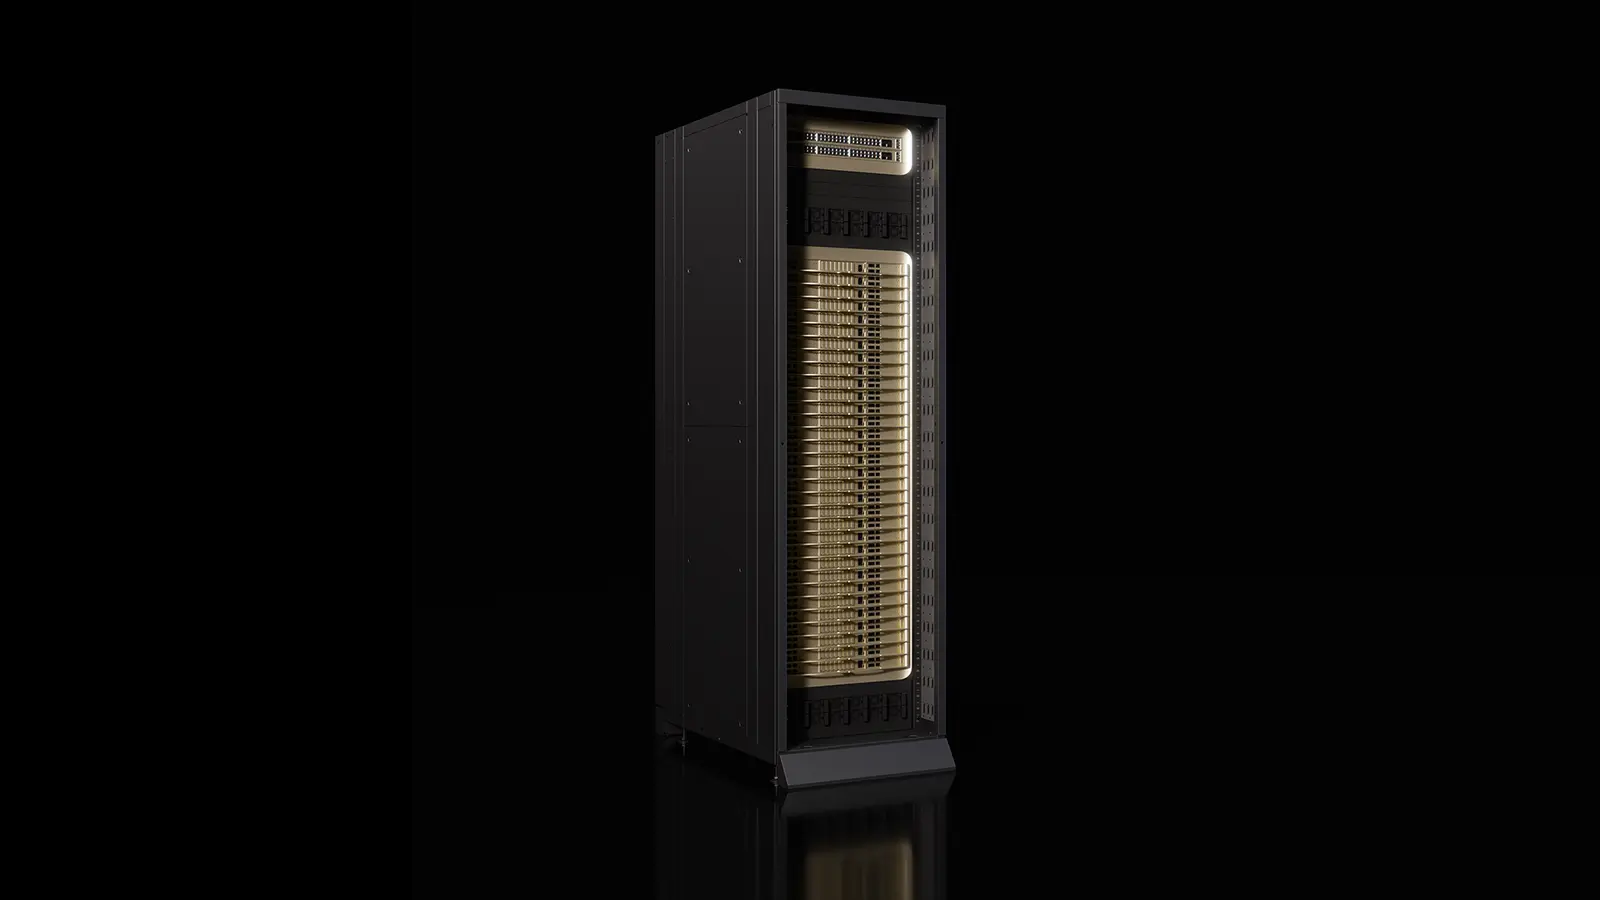
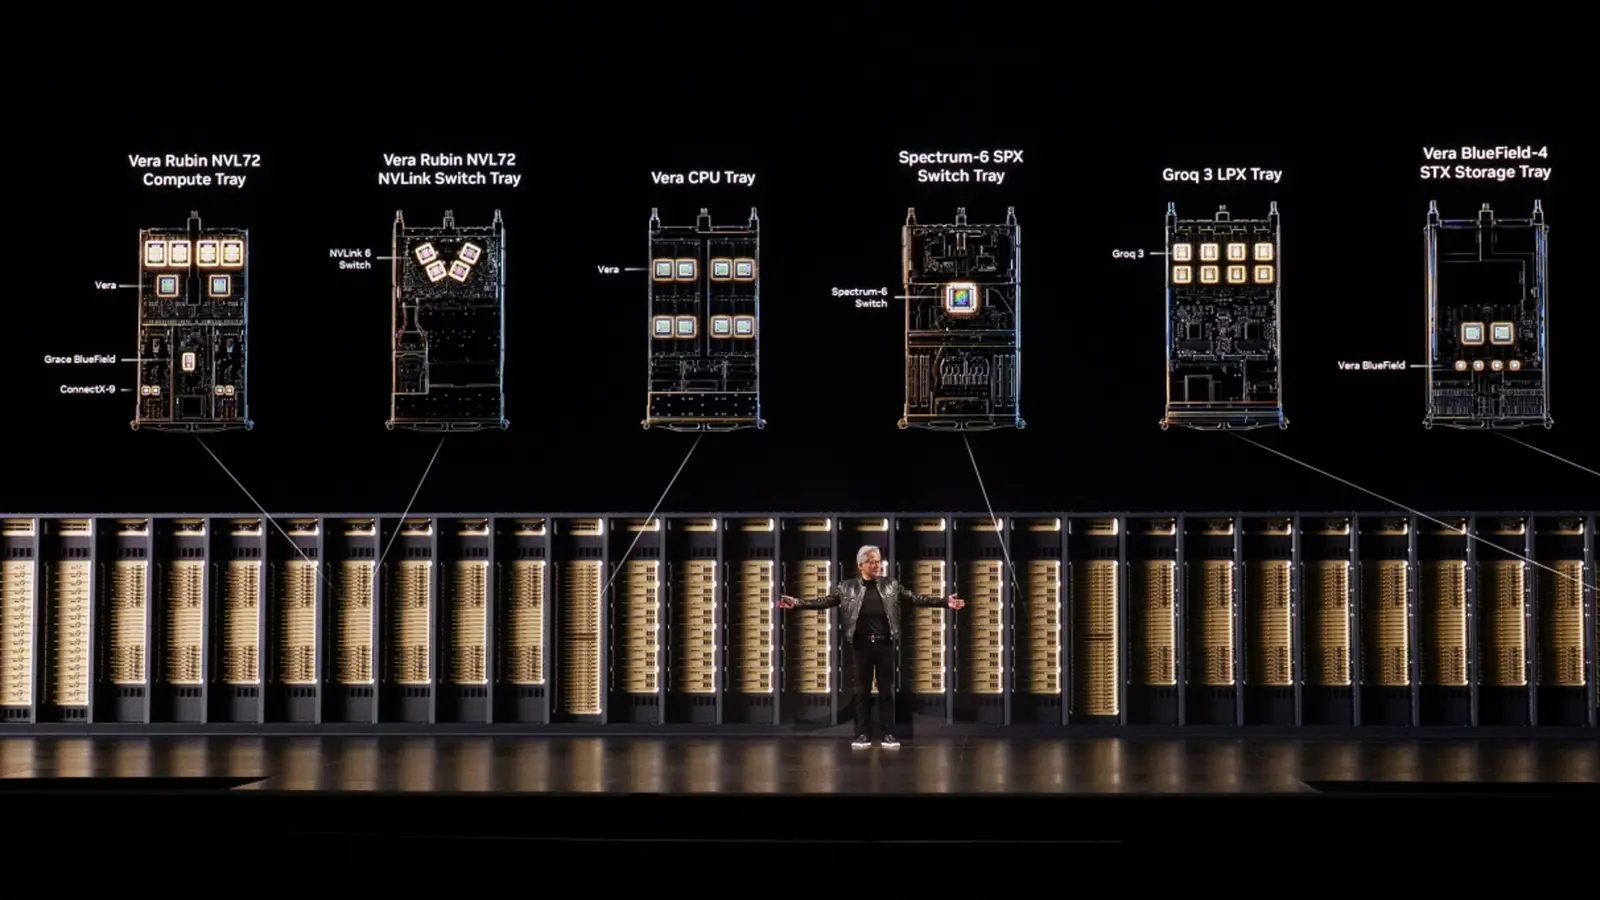
参考として、NVIDIAのラック構成を伝える別の報道は、Vera Rubin NVL72を72基のRubin GPUと36基のVera CPUで構成されると説明している。
数字は何を示すのか
NVIDIAの結果は、SemiAnalysis AgentXのDeepSeek V4 Proワークロードによるものだ。
- GB300 NVL72とH200の比較:ユーザー当たり毎秒100トークンで、ドル当たり処理量は最大10x。GPU当たりのHBM容量はおよそ2倍になった。
- Vera Rubin NVL72とGB300 NVL72の比較:ユーザー当たり毎秒125トークンで、ドル当たり処理量は最大30x。GPU当たりのHBM容量は約3%の増加にとどまる。
NVIDIAは、事業者にとって重要なのは、電力の枠内で応答時間の要件を満たしながら、どれだけ有用なトークンを出せるかだと述べる。また、HBM3eとHBM4をアクセラレーテッドコンピューティング基盤に最初に採用したと主張している。
価格
NVIDIAはこの投稿で価格を示しておらず、Vera Rubinシステムの出荷日も明らかにしていない。メモリ供給が逼迫して価格が上がり、この傾向は当面続く見通しだとは述べている。見積もりはNVIDIAかサーバーの納入元に確認してほしい。
向いている人
データセンターとクラウドの購入者。推論をトークン単位で支払うなら、この主張の重みは大きい。ドル当たりとワット当たりの処理量を、自社の負荷で確認してもらうのがよい。
AI開発者。NVFP4のチェックポイントで公開されたモデルや、Dynamo、cuVSといったツールは、今すぐ検証できる実用的な部分である。
一般のPCやスマホの購入者。ラック規模のサーバー機器で、消費者向け製品は直接ない。説明されたメモリの逼迫は、投稿が価格を押し上げているとする供給圧力と同じものだ。
待つべき人。この数字を根拠に購入を考えるなら、独立したテストを待つほうがよい。数字はNVIDIA発で、単一のテスト負荷に基づくためだ。
まだ分からないこと
NVIDIAは、向上分のうちメモリ手法と演算性能そのものの改善がそれぞれどれだけかを示していない。他の負荷での結果も不明だ。独立した検証と価格が、顧客にどこまで届くかを示すだろう。
次の一手:元の投稿にある技術解説と動画を読み、AgentXの結果を自社のモデルとコンテキスト長に照らして比べたい。