NVIDIA asegura que su plataforma Vera Rubin eleva hasta 30x el rendimiento agéntico por dólar frente a Blackwell Ultra, mientras la capacidad de HBM por GPU sube solo alrededor de 3%. La empresa publicó la afirmación el 5 de noviembre de 2026 y sostiene que poner más memoria en un chip no resuelve un suministro limitado y precios al alza.
En su lugar, NVIDIA habla de diseño conjunto: GPU, CPU, redes, almacenamiento y software pensados en conjunto para que cada byte de memoria haga más trabajo. Las cifras provienen del blog de NVIDIA y de una prueba que cita, SemiAnalysis AgentX, así que son afirmaciones del fabricante.
¿Por qué la memoria es el cuello de botella de los servidores de IA?
Modelos más grandes, contextos más largos y aplicaciones con agentes presionan más la memoria de las GPU, según NVIDIA. La HBM, la memoria de alto ancho de banda junto a la GPU, es el nivel más rápido y caro, y los pesos del modelo y el caché KV compiten por ella.
El caché KV guarda el contexto que el modelo necesita para cada solicitud activa. NVIDIA explica que las sesiones agénticas arrastran contexto entre llamadas repetidas al modelo y a herramientas, en algunos casos hasta 3 million de tokens, por lo que la memoria de trabajo crece. La generación aumentada con recuperación (RAG) suma todavía más contexto.
NVIDIA señala además un límite que llama el muro de la memoria. Más HBM puede guardar el contexto de más usuarios, pero todos comparten el mismo cómputo y ancho de banda. Cuando el ancho de banda no alcanza, la capacidad extra queda ociosa, aunque sigue sumando costo y consumo de energía.
¿Qué hace NVIDIA al respecto?
NVIDIA enumera tres técnicas, cada una dirigida a una fuente distinta de desperdicio:
- Pesos más pequeños. El formato NVFP4 ocupa menos espacio que FP8, la precisión más baja que admite Hopper. Dentro de un sistema NVL72, los pesos se pueden repartir entre hasta 72 GPU, lo que deja más HBM para el caché KV. NVIDIA menciona varios modelos recientes con puntos de control NVFP4, entre ellos su propio Nemotron 3.5 Super VL.
- Caché KV más pequeño y movible. NVFP4 reduce el caché KV frente a FP8. La CPU Vera acorta el tiempo de espera durante las llamadas a herramientas, y su gran memoria LPDDR, conectada a las GPU Rubin por NVLink-C2C, da un lugar cercano al contexto en pausa. El software Dynamo también puede mover contexto inactivo al almacenamiento CMX, un nivel que NVIDIA dice cuesta mucho menos por bit que la HBM.
- Datos de recuperación más ligeros. Los modelos Nemotron Retriever generan vectores más pequeños y la biblioteca cuVS permite alojar el índice en CPU y almacenamiento, así que la base de conocimiento nunca ocupa HBM.
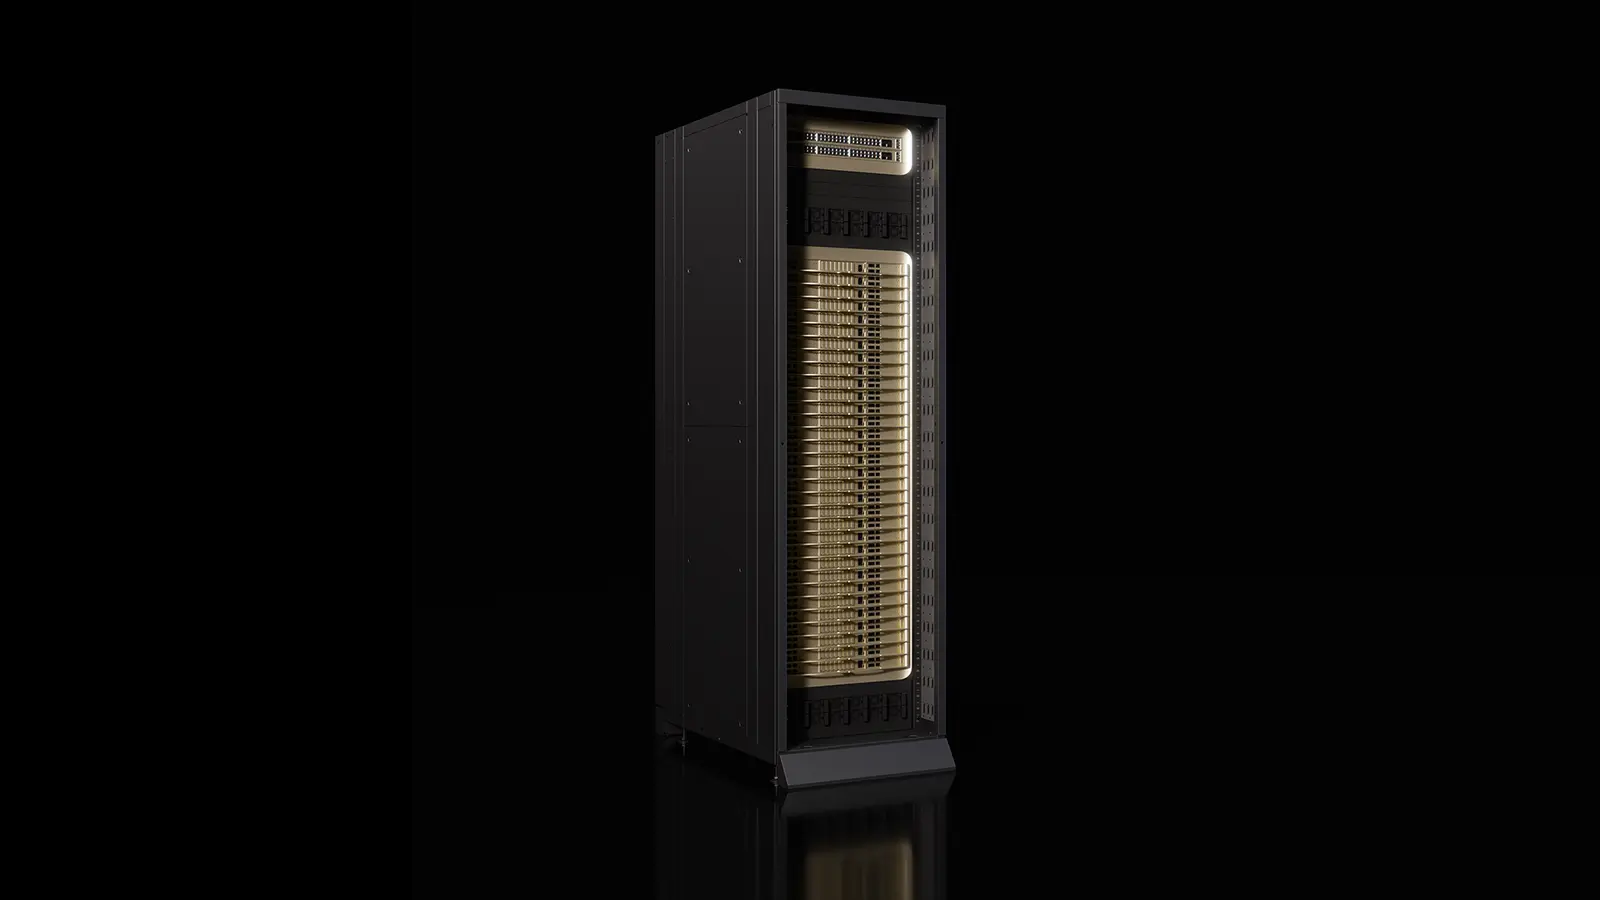
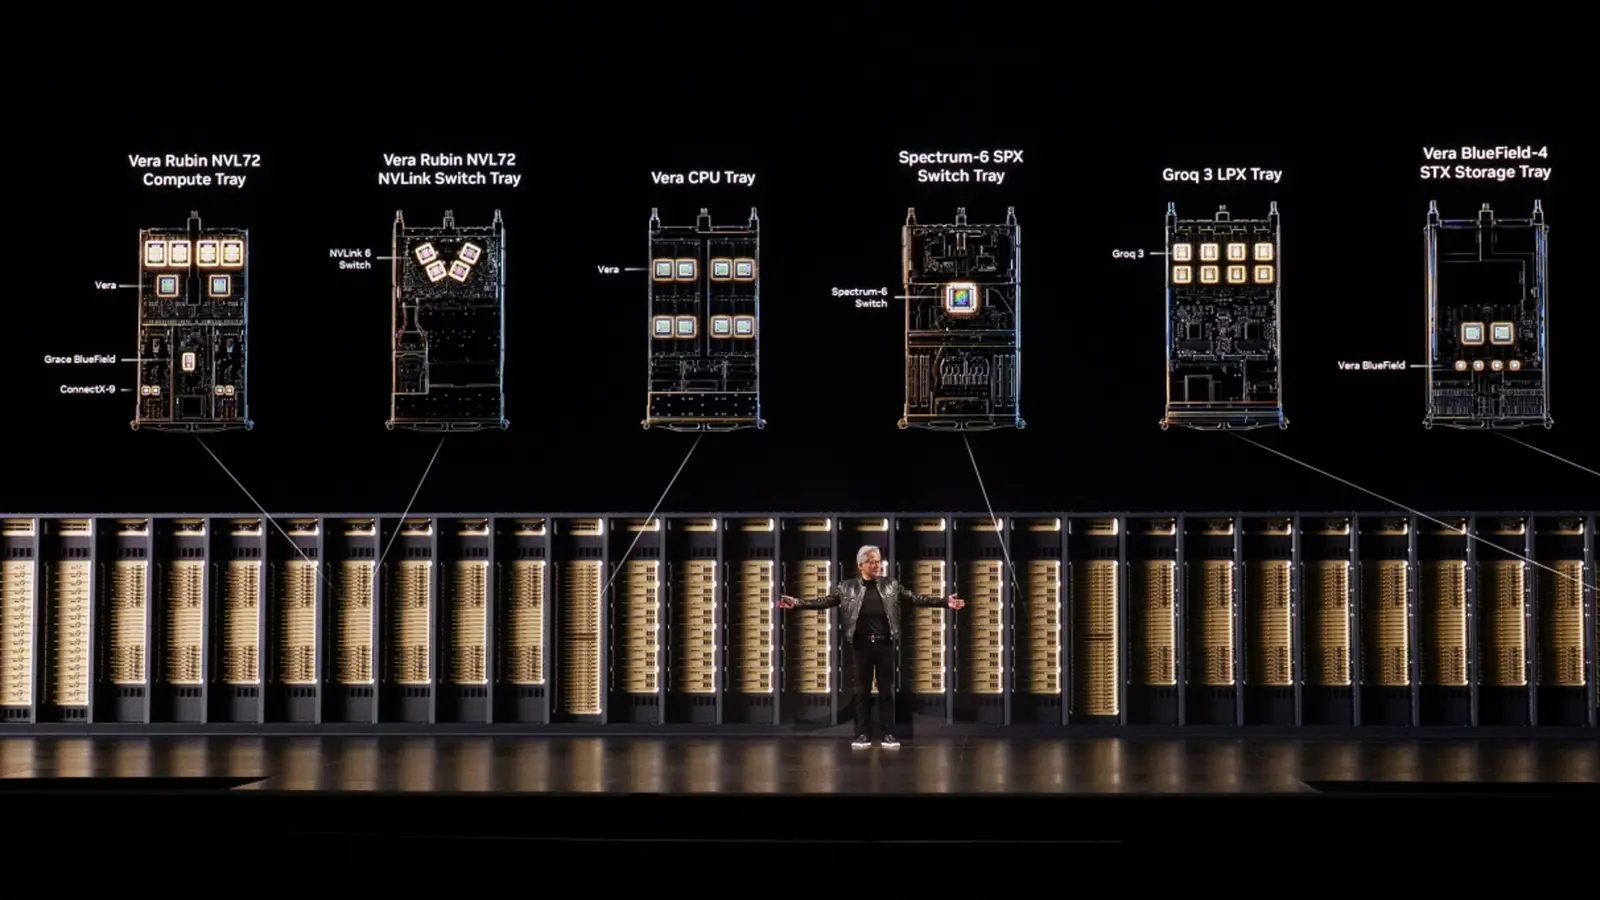
Como contexto, otro reporte sobre los racks de NVIDIA describe el Vera Rubin NVL72 como un conjunto de 72 GPU Rubin y 36 CPU Vera.
¿Qué dicen las cifras?
Los resultados de NVIDIA provienen de la carga SemiAnalysis AgentX con DeepSeek V4 Pro:
- GB300 NVL72 frente a H200: hasta 10x más rendimiento por dólar a 100 tokens por segundo por usuario, con la capacidad de HBM por GPU casi duplicada.
- Vera Rubin NVL72 frente a GB300 NVL72: hasta 30x más rendimiento por dólar a 125 tokens por segundo por usuario, con la capacidad de HBM por GPU arriba cerca de 3%.
NVIDIA dice que lo que importa a los operadores es cuántos tokens útiles entrega la planta dentro de su presupuesto de energía y con tiempos de respuesta aceptables. También afirma haber sido la primera en adoptar HBM3e y HBM4 en una pila de cómputo acelerado.
Precios
NVIDIA no indica precios en esta publicación ni fechas de envío de los sistemas Vera Rubin. Sí dice que el suministro de memoria se estrecha y los precios suben, una tendencia que espera que continúe a corto plazo. Para cotizaciones, consulte a NVIDIA o a su proveedor de servidores.
A quién le interesa
Centros de datos y nube. El argumento pesa más si paga la inferencia por token. El rendimiento por dólar y por watt son las cifras que conviene pedir al proveedor que confirme con su propia carga.
Desarrolladores de IA. Los modelos con puntos de control NVFP4 y herramientas como Dynamo y cuVS son lo concreto que se puede revisar hoy.
Quien compra laptop o celular. Es hardware de servidor a escala de rack, sin producto directo para el consumidor. La escasez de memoria que describe es la misma presión de suministro que, según la publicación, empuja los precios.
Quién debería esperar. Quien planee comprar con base en estas cifras debería esperar pruebas independientes, porque son de NVIDIA y se apoyan en una sola carga de prueba.
Lo que aún no se sabe
NVIDIA no explica cómo se reparten las mejoras entre las técnicas de memoria y el avance bruto de cómputo, ni cómo cambian los resultados con otras cargas. Las pruebas independientes y los precios mostrarán cuánto llega a los clientes.
Siguiente paso: lea el análisis técnico y el video explicativo enlazados en la publicación original, y compare los resultados de AgentX con sus propios modelos y longitudes de contexto.