NVIDIA affirme que sa plateforme Vera Rubin multiplie par 30 au maximum le débit agentique par dollar par rapport à Blackwell Ultra, alors que la capacité HBM par GPU n’augmente que d’environ 3%. L’entreprise a publié cette affirmation le 5 novembre 2026 et soutient que loger plus de mémoire sur une puce ne règle pas le problème d’un approvisionnement tendu et de prix en hausse.
NVIDIA parle plutôt de conception conjointe : GPU, CPU, réseau, stockage et logiciels pensés ensemble pour que chaque octet de mémoire serve davantage. Les chiffres viennent du blogue de NVIDIA et d’un banc d’essai qu’elle cite, SemiAnalysis AgentX. Ce sont donc des affirmations du fabricant.
Pourquoi la mémoire limite-t-elle les serveurs d’IA ?
Les modèles plus gros, les contextes plus longs et les agents font monter la pression sur la mémoire des GPU, selon NVIDIA. La HBM, la mémoire à haute bande passante placée près du GPU, est le niveau le plus rapide et le plus cher, et les poids du modèle comme le cache KV se la disputent.
Le cache KV conserve le contexte dont le modèle a besoin pour chaque requête active. NVIDIA indique que les sessions agentiques reportent le contexte d’un appel de modèle ou d’outil à l’autre, parfois jusqu’à 3 million de jetons, si bien que la mémoire de travail ne cesse de croître. La génération augmentée par récupération (RAG) ajoute encore du contexte.
NVIDIA évoque aussi une limite qu’elle appelle le mur de la mémoire. Davantage de HBM permet de garder le contexte de plus d’utilisateurs, mais tous partagent le même calcul et la même bande passante. Quand la bande passante ne suit plus, la capacité ajoutée reste inutilisée tout en coûtant de l’argent et de l’énergie.
Que fait NVIDIA pour y remédier ?
NVIDIA cite trois techniques, chacune ciblant une source de gaspillage :
- Des poids plus compacts. Le format NVFP4 occupe moins d’espace que le FP8, la précision la plus basse prise en charge par Hopper. Dans un système NVL72, les poids peuvent être répartis sur jusqu’à 72 GPU, ce qui laisse plus de HBM au cache KV. NVIDIA cite plusieurs modèles récents publiés avec des points de contrôle NVFP4, dont son propre Nemotron 3.5 Super VL.
- Un cache KV plus petit et déplaçable. Le NVFP4 réduit le cache KV par rapport au FP8. Le CPU Vera raccourcit l’attente pendant les appels d’outils, et sa grande mémoire LPDDR, reliée aux GPU Rubin par NVLink-C2C, offre un lieu d’attente proche. Le logiciel Dynamo peut aussi déplacer le contexte inactif vers le stockage CMX, un palier que NVIDIA dit bien moins coûteux par bit que la HBM.
- Des données de recherche allégées. Les modèles Nemotron Retriever produisent des vecteurs plus petits, et la bibliothèque cuVS permet de loger l’index sur le CPU et le stockage : la base de connaissances n’occupe jamais la HBM.
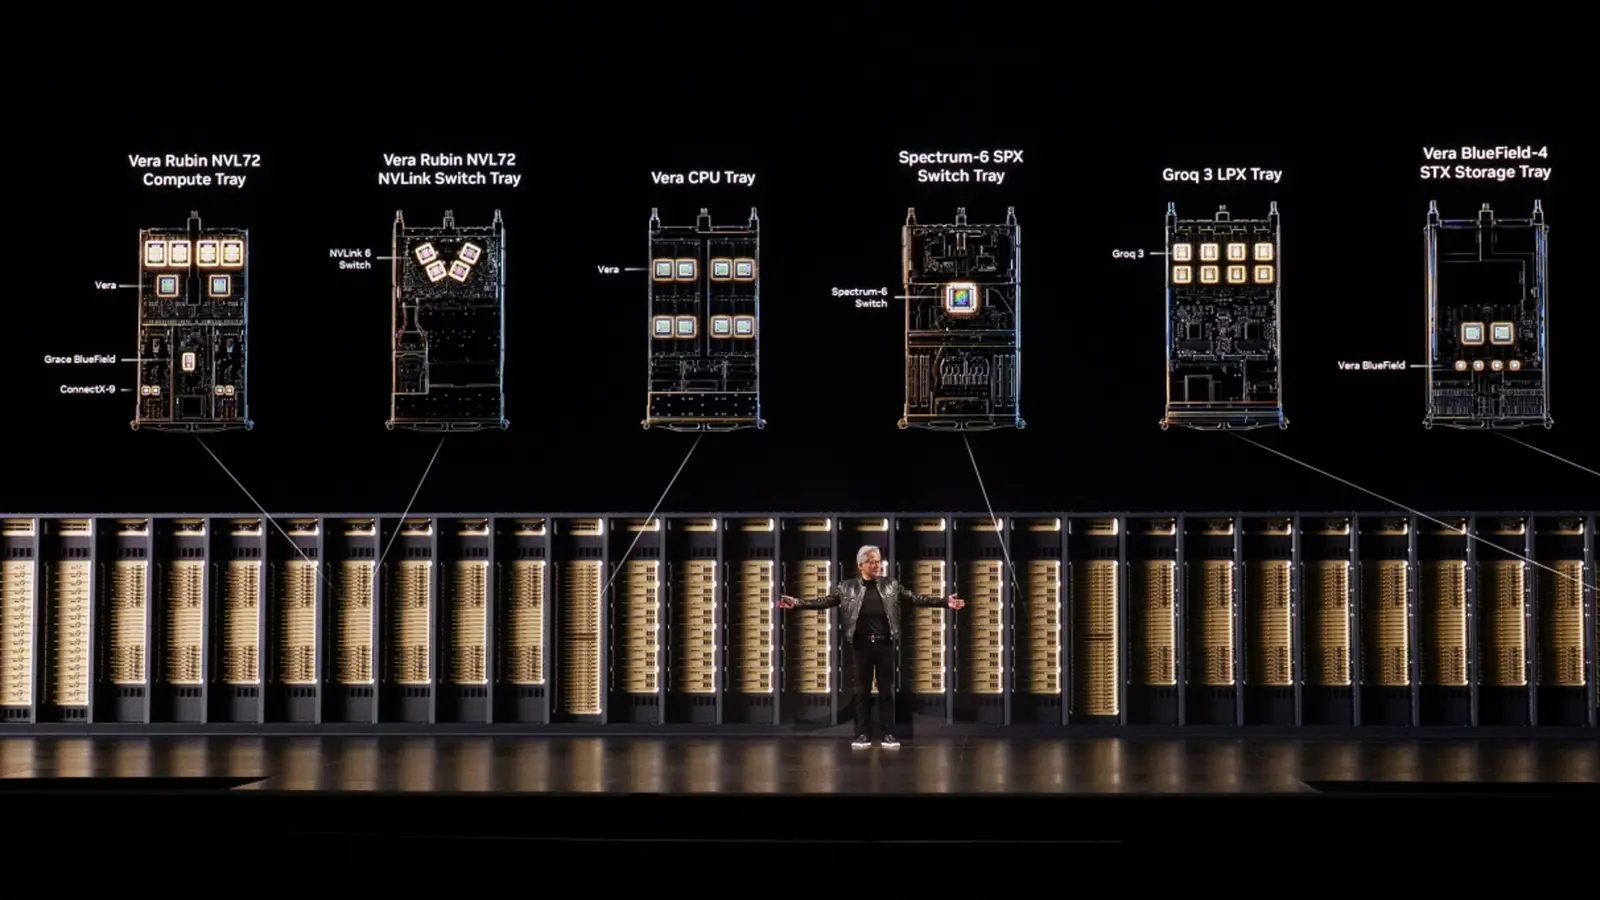
À titre de contexte, un autre article sur les racks de NVIDIA décrit le Vera Rubin NVL72 comme un ensemble de 72 GPU Rubin et de 36 CPU Vera.
Que disent les chiffres ?
Les résultats de NVIDIA proviennent de la charge SemiAnalysis AgentX avec DeepSeek V4 Pro :
- GB300 NVL72 contre H200 : jusqu’à 10x plus de débit par dollar à 100 jetons par seconde par utilisateur, avec une capacité HBM par GPU à peu près doublée.
- Vera Rubin NVL72 contre GB300 NVL72 : jusqu’à 30x plus de débit par dollar à 125 jetons par seconde par utilisateur, avec une capacité HBM par GPU en hausse d’environ 3%.
Selon NVIDIA, ce qui compte pour les exploitants, c’est le nombre de jetons utiles livrés dans une enveloppe de puissance donnée tout en respectant les temps de réponse. L’entreprise dit aussi avoir été la première à adopter HBM3e et HBM4 dans une pile de calcul accéléré.
Prix
NVIDIA n’indique aucun prix dans cet article, ni date de livraison pour les systèmes Vera Rubin. Elle précise toutefois que l’offre de mémoire se resserre et que les prix montent, une tendance qui devrait se poursuivre à court terme. Pour une soumission, il faut s’adresser à NVIDIA ou à son fournisseur de serveurs.
À qui cela s’adresse
Centres de données et infonuagique. L’argument pèse surtout si vous payez l’inférence au jeton. Le débit par dollar et par watt sont les chiffres à faire confirmer sur votre propre charge de travail.
Développeurs d’IA. Les modèles publiés avec des points de contrôle NVFP4 et les outils comme Dynamo et cuVS sont la partie concrète que l’on peut examiner dès maintenant.
Acheteurs d’ordinateurs et de téléphones. Il s’agit de matériel de serveur à l’échelle du rack, sans produit direct pour le grand public. La pénurie de mémoire décrite est la même pression d’approvisionnement qui, selon l’article, fait monter les prix.
Ceux qui devraient attendre. Quiconque prévoit un achat à partir de ces chiffres devrait attendre des tests indépendants, car ils viennent de NVIDIA et reposent sur une seule charge de test.
Ce que l’on ignore encore
NVIDIA ne dit pas comment les gains se répartissent entre les techniques mémoire et l’amélioration brute du calcul, ni comment les résultats changent selon d’autres charges. Des tests indépendants et les prix diront quelle part de ces gains atteint les clients.
Prochaine étape : lire l’analyse technique et la vidéo explicative liées à l’article d’origine, puis comparer les résultats AgentX avec vos propres modèles et longueurs de contexte.