NVIDIA는 Vera Rubin 플랫폼의 에이전트 처리량이 Blackwell Ultra보다 달러당 최대 30x 높아지는 반면, GPU당 HBM 용량은 약 3%만 늘었다고 주장했다. 회사는 2026년 11월 5일 이 내용을 공개하며, 공급이 빠듯하고 가격이 오르는 상황에서 칩에 메모리를 더 얹는 것만으로는 답이 되지 않는다고 설명했다.
NVIDIA가 내세운 것은 전체 스택 공동 설계다. GPU, CPU, 네트워크, 스토리지, 소프트웨어를 함께 설계해 메모리 1바이트가 더 많은 일을 하게 한다는 구상이다. 수치는 NVIDIA 자체 블로그와 회사가 인용한 SemiAnalysis AgentX 벤치마크에서 나온 것이므로 제조사의 주장으로 보아야 한다.
왜 메모리가 AI 서버의 병목인가
NVIDIA에 따르면 모델이 커지고 컨텍스트가 길어지며 에이전트 앱이 늘면서 GPU 메모리 부담이 커지고 있다. GPU 옆의 고대역폭 메모리인 HBM은 가장 빠르고 비싼 계층이며, 모델 가중치와 KV 캐시가 이 공간을 놓고 경쟁한다.
KV 캐시는 활성 요청마다 모델이 필요로 하는 문맥을 담는다. NVIDIA는 에이전트 작업이 모델과 도구 호출을 반복하며 앞선 문맥을 이어 가고, 경우에 따라 최대 3 million개 토큰을 처리한다고 밝혔다. 작업 메모리는 계속 커진다. 검색 증강 생성(RAG)은 문맥을 더 늘린다.
NVIDIA는 이른바 메모리 장벽도 언급했다. HBM이 많으면 더 많은 사용자의 문맥을 담을 수 있지만, 모든 사용자가 같은 연산 자원과 대역폭을 나눠 쓴다. 대역폭이 연산 속도를 따라가지 못하면 추가 용량은 놀고, 비용과 전력만 늘어난다.
NVIDIA는 어떻게 대응하나
NVIDIA는 낭비 원인별로 세 가지 기법을 든다.
- **가중치 축소.**NVFP4 형식은 FP8보다 공간을 덜 쓴다. FP8은 Hopper 플랫폼이 지원하는 가장 낮은 정밀도다. NVL72 시스템에서는 가중치를 최대 72개 GPU에 나눠 담을 수 있어 각 GPU의 HBM을 KV 캐시에 더 쓸 수 있다. NVIDIA는 자사 Nemotron 3.5 Super VL을 포함한 여러 최신 모델이 NVFP4 체크포인트로 공개됐다고 소개했다.
- **KV 캐시 축소와 이동.**NVFP4를 적용하면 KV 캐시가 FP8보다 작아진다. Vera CPU는 도구 호출 중 유휴 시간을 줄이고, NVLink-C2C로 Rubin GPU와 연결된 대용량 LPDDR 메모리는 멈춘 문맥이 가까이서 대기하게 한다. Dynamo 소프트웨어는 쓰이지 않는 문맥을 CMX 컨텍스트 메모리 스토리지로 옮길 수 있으며, NVIDIA는 이 계층의 비트당 비용이 HBM보다 훨씬 낮다고 말한다.
- **검색 데이터 경량화.**Nemotron Retriever 모델은 더 작은 임베딩을 만들고, cuVS 라이브러리는 색인을 CPU와 스토리지에 둘 수 있게 한다. 지식 베이스가 HBM을 차지하지 않는다.
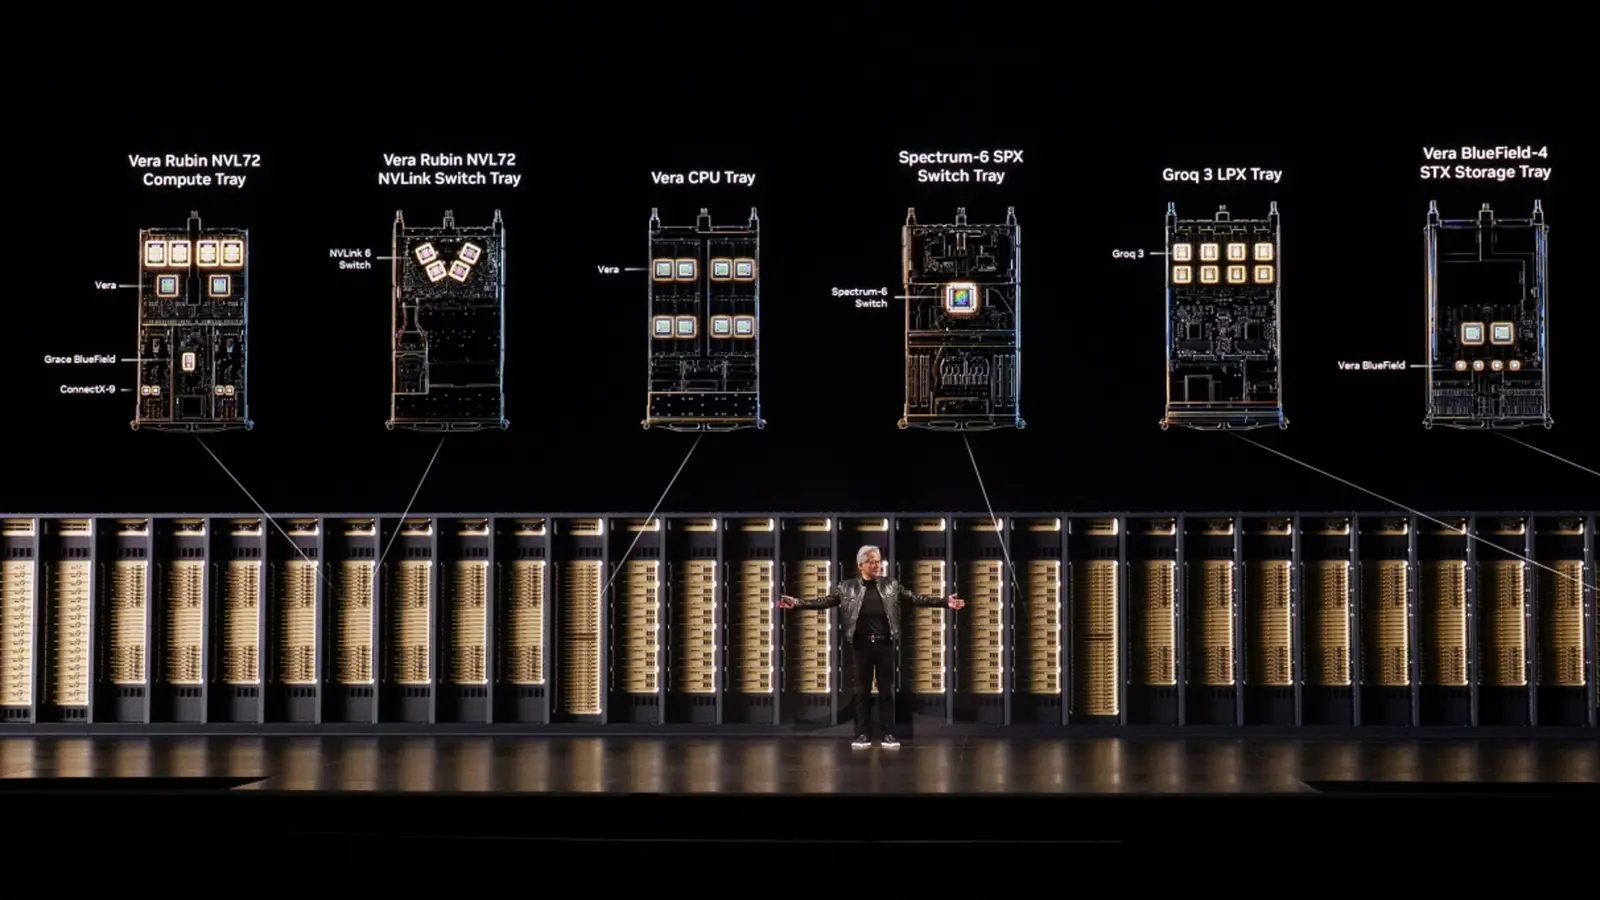
참고로 NVIDIA의 랙 계획을 다룬 다른 보도는 Vera Rubin NVL72가 72개의 Rubin GPU와 36개의 Vera CPU로 구성된다고 전한다.
수치는 무엇을 말하나
NVIDIA의 결과는 SemiAnalysis AgentX의 DeepSeek V4 Pro 워크로드에서 나왔다.
- GB300 NVL72 대 H200: 사용자당 초당 100 토큰에서 달러당 처리량이 최대 10x이며, GPU당 HBM 용량은 대략 두 배가 됐다.
- Vera Rubin NVL72 대 GB300 NVL72: 사용자당 초당 125 토큰에서 달러당 처리량이 최대 30x이며, GPU당 HBM 용량은 약 3% 늘었다.
NVIDIA는 사업자에게 중요한 것이 전력 한도 안에서 응답 시간 요건을 맞추며 얼마나 많은 유용한 토큰을 내놓느냐라고 말했다. 또 HBM3e와 HBM4를 가속 컴퓨팅 스택에 가장 먼저 채택했다고 주장했다.
가격
NVIDIA는 이 글에서 가격을 밝히지 않았고 Vera Rubin 시스템의 출하 일정도 공개하지 않았다. 다만 메모리 공급이 빠듯해지고 가격이 오르고 있으며 이 추세가 단기간 이어질 것으로 본다고 했다. 견적은 NVIDIA나 서버 공급업체에 문의해야 한다.
어떤 독자에게 맞나
**데이터센터와 클라우드 구매자.**추론 비용을 토큰 단위로 낸다면 이 주장이 가장 중요하다. 달러당, 와트당 처리량을 자사 워크로드로 확인해 달라고 업체에 요청하는 것이 좋다.
**AI 개발자.**NVFP4 체크포인트로 나온 모델과 Dynamo, cuVS 같은 도구가 지금 살펴볼 수 있는 실용적인 부분이다.
**일반 PC와 스마트폰 구매자.**랙 규모의 서버 하드웨어라 소비자용 제품은 직접 없다. 글이 설명한 메모리 부족은 가격을 밀어 올린다고 한 바로 그 공급 압력이다.
**기다려야 할 사람.**이 수치를 근거로 구매를 계획한다면 독립 테스트를 기다리는 편이 낫다. 수치는 NVIDIA가 내놓았고 하나의 테스트 워크로드에 기반하기 때문이다.
아직 알려지지 않은 것
NVIDIA는 개선분이 메모리 기법과 연산 성능 향상에 각각 얼마나 나뉘는지, 다른 워크로드에서 결과가 어떻게 달라지는지 밝히지 않았다. 독립 벤치마크와 가격이 고객에게 얼마나 돌아가는지 보여 줄 것이다.
다음 단계: 원문에 링크된 기술 해설과 영상을 읽고, AgentX 결과를 자사 모델과 컨텍스트 길이에 비춰 비교해 보자.