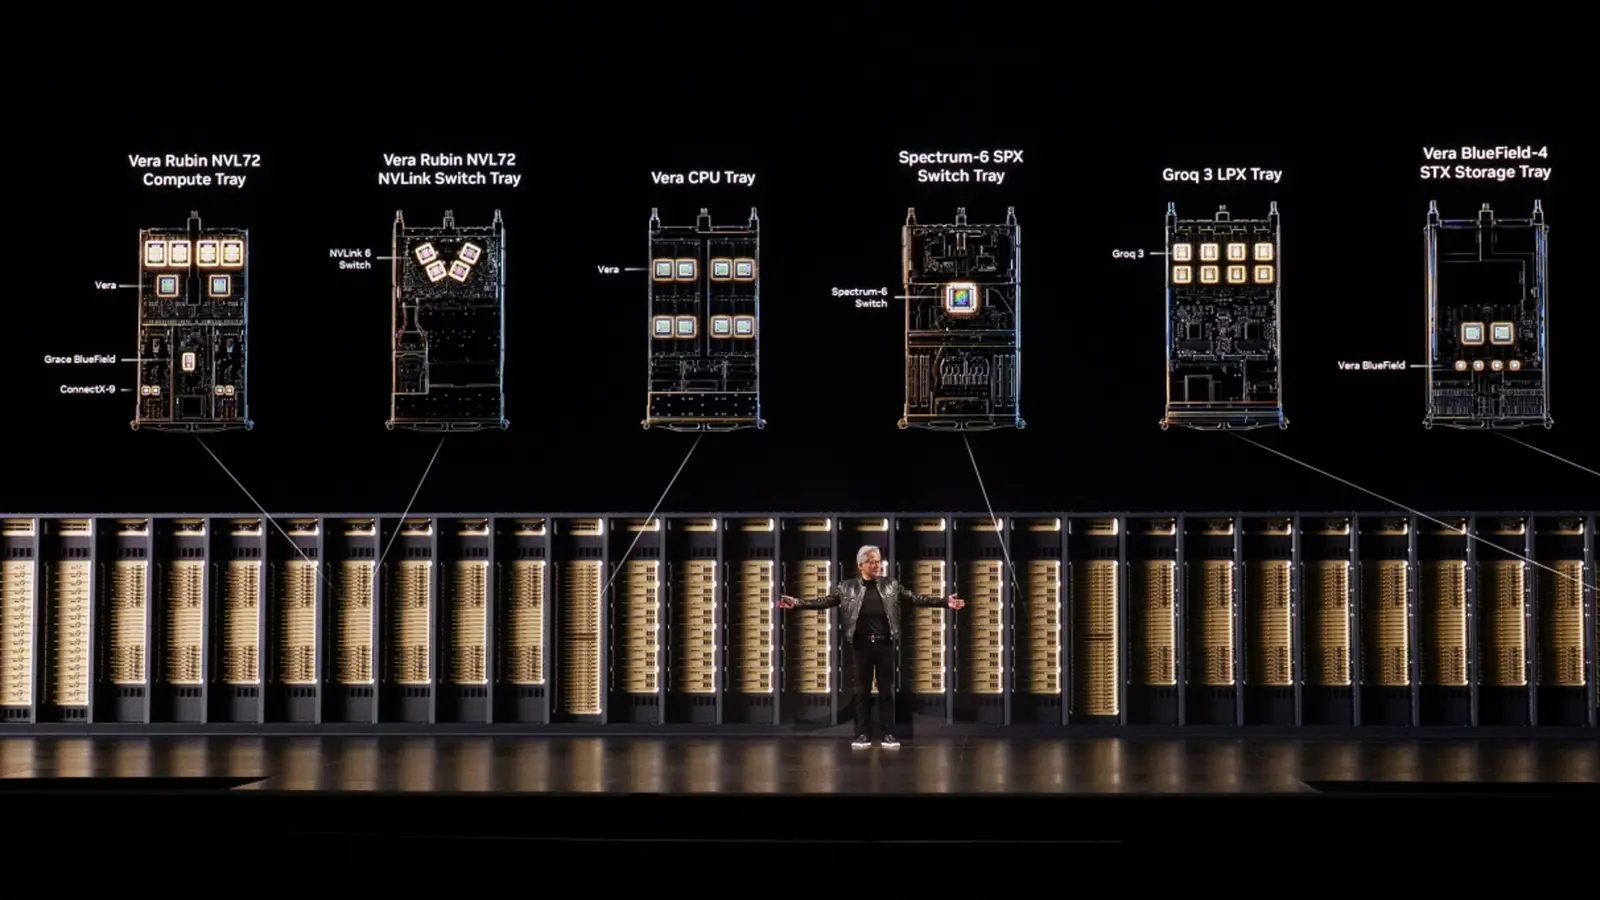
NVIDIA 表示,旗下 Vera CPU 运行 AI 代理工作负载的速度快过最快的 x86 处理器,而且在相同电力预算下可容纳 1.6x 数量的代理。公司于 2026 年 11 月 5 日公布这项说法,并附上六间合作伙伴的测试结果。
这项方案针对受电力而非空间限制的数据中心营运商。NVIDIA 指,一颗 Vera 芯片可取代现时供应商为平衡速度与容量而混用的快速及高密度 x86 处理器。
为何 AI 代理需要 CPU?
代理在模型推理以外的每一步都依赖 CPU。据 NVIDIA 说明,代理会搜索资料、查询数据库、编写及测试程序码并采取行动,工作过程中不断在 GPU 推理与 CPU 执行之间切换。
随着更多企业部署代理,CPU 一端必须快速执行这些步骤,并同时支持大量代理。NVIDIA 把负责这类工作的设施称为 AI 工厂,并指它们受电力限制,因此目标是每瓦特完成最多工作。
Vera 与 x86 芯片相比如何?
NVIDIA 以 100 兆瓦数据中心作比较,声称单一 Vera CPU 同时胜过最快的 x86 CPU 及最节能的 x86 CPU。以下为公司自家数字:
- 对比最快的 x86 CPU:代理速度业界领先,每瓦特可支持 1.6x 数量的代理
- 对比最节能的 x86 CPU:代理速度快 2x,能源效率亦属领先
NVIDIA 在公告中没有列出 x86 型号,因此暂时无法把说法对应到具体的 Intel 或 AMD 产品。
早期客户有何结果?
NVIDIA 列出六间伙伴的接近实际运作测试,结果均来自公司自己的文章:
- Perplexity:运行代理式编程任务比传统 CPU 快 1.5x,并计划在日后的生产系统部署 Vera。
- DeepInfra:在其生产代理工作负载的代理编排上,速度最高达到最佳 x86 处理器的 2.2x。
- ClickHouse:标准程序未经 Vera 专门调校,在 176 核心上接近线性扩展,并登上 ClickBench 硬件排行榜首位。
- DuckLabs:TPC-H SF1000 中位数表现约为 Intel Xeon 6 基准的 1.5x。
- Daytona:以 10.8 秒让 1,000 个代理沙盒上线,x86 则需 88.4 秒,并在 2,000 个同时运行的沙盒下达到每秒 12.7 个完成工作。
- Modal:每核心沙盒吞吐量最高为同类 x86 硬件的 2x,负载越重差距越大。
DeepInfra 亦在 2026 年 7 月发表自己的分析:在抢先体验的 Vera 硬件上,Vera 于 20 核心分区内可维持 256 个同时运行的代理,而其测试的现有芯片为 160 个。由于 DeepInfra 既营运平台又自行测试,应视为供应商的结果。
价格及购买方式?
公告没有提供价格、服务器厂商名单或出货日期。Vera 是数据中心处理器,一般读者不会直接购买。服务器价格将来自云端服务供应商及系统组装商,NVIDIA 在此并未点名。
适合谁
AI 基础设施供应商。 一颗 CPU 应付多种代理工作负载,受电力限制的营运商多了一个可与现有 x86 机架比较的选择。
运行编程代理或沙盒的企业。 Perplexity、Daytona 及 Modal 的数字都与这类用途最接近。
数据库及分析团队。 ClickHouse 与 DuckLabs 的结果显示 Vera 亦用于查询工作,但两者都只是单项测试。
应该等待的人。 计划采购者宜等候独立测试,因为目前几乎所有数字都来自 NVIDIA 或其伙伴。
仍未知的事
公告没有说明所用的 x86 芯片、100 兆瓦比较的测试设置、Vera 的价格,以及服务器何时出货。
下一步
请阅读公告所链接的 NVIDIA Vera CPU 页面,并留意列明 x86 芯片及工作负载的独立测试。