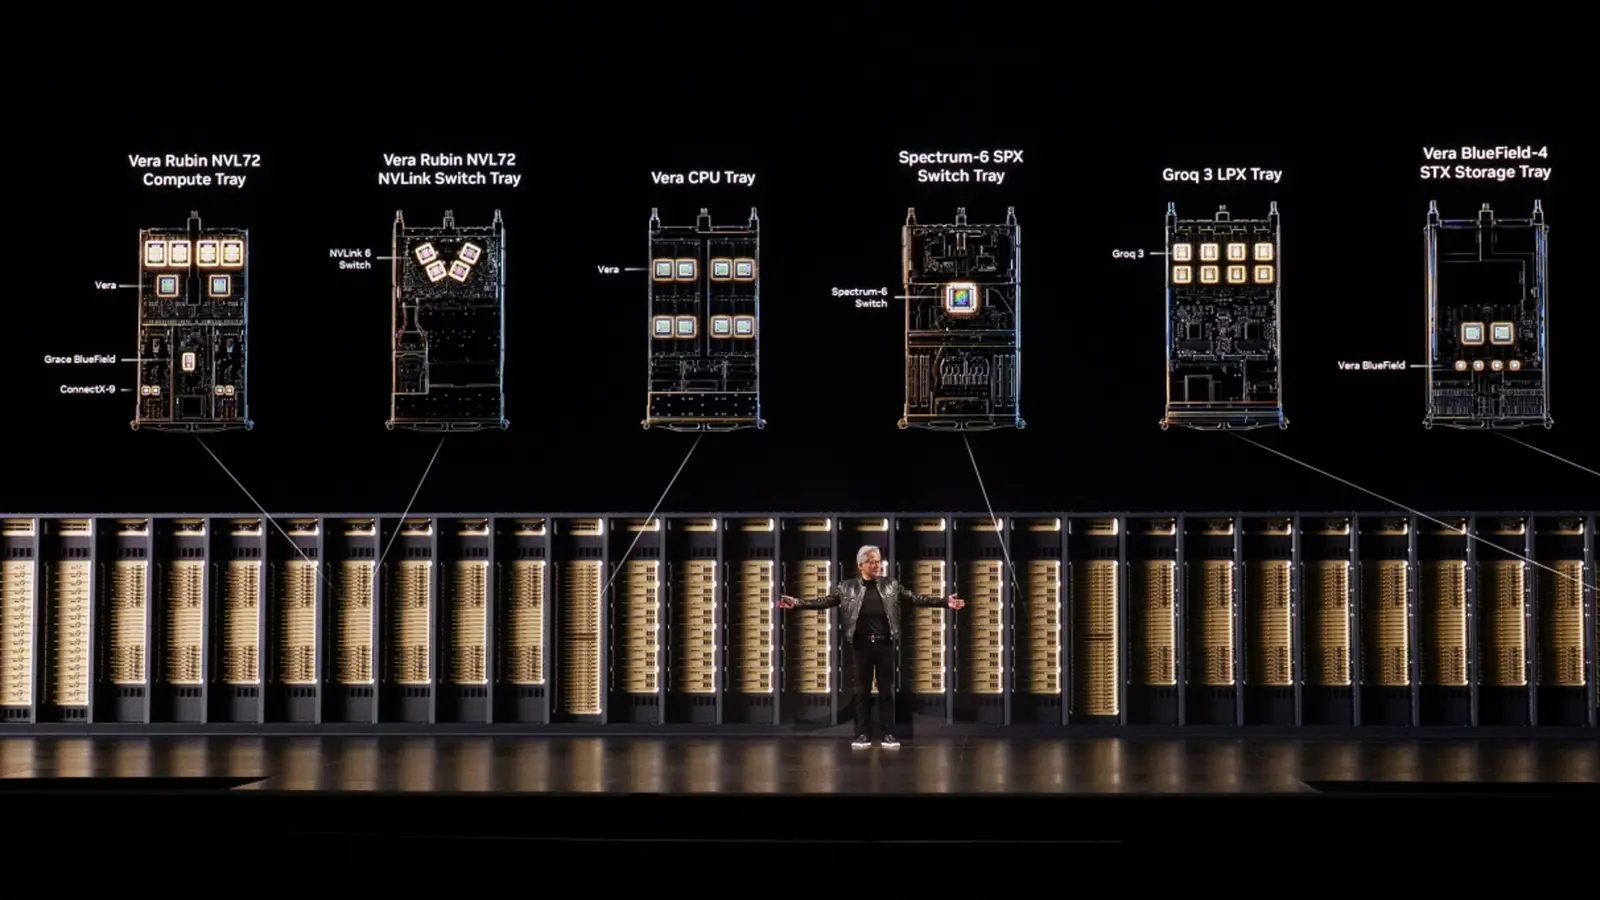
Les équipes qui entraînent des modèles d’IA paient chaque heure d’utilisation de leurs GPU : un système plus rapide réduit la facture et accélère le lancement. Le 16 novembre 2026, NVIDIA a déclaré que son nouveau système Vera Rubin NVL72 offrait jusqu’à 2x plus de performance par GPU que le GB300 NVL72 dans MLPerf Training v6.1, la série de tests publiée par MLCommons.
NVIDIA ajoute qu’elle était la seule plateforme à avoir des résultats pour chaque test de cette ronde, et que, pour sa première participation à MLPerf Endpoints, Vera Rubin a fourni plus de 10x le débit par watt du GB300 NVL72 pour l’IA agentique. NVIDIA fabrique les deux systèmes : ce sont donc ses propres affirmations sur ses propres résultats.
Que mesure MLPerf Training v6.1 ?
MLPerf Training mesure la vitesse à laquelle un système entraîne un modèle jusqu’à un niveau de précision cible. Selon MLCommons, la ronde a réuni 153 systèmes et 250 résultats de 24 organisations. Les systèmes infonuagiques en représentent 57, soit 37 % du total, contre 29 % à la ronde précédente. 12 systèmes utilisaient 1 000 accélérateurs ou plus, et le plus grand en comptait 10 240.
Deux tests sont nouveaux : DLRMv4-HSTU, pour les systèmes de recommandation, et Qwen3.5-397B, premier test de post-entraînement de la suite. NVIDIA dit avoir couvert les grands modèles de langage, la génération d’images, les systèmes de recommandation et l’apprentissage par renforcement en post-entraînement.
Quelle est la vitesse de Vera Rubin ?
Le gain par GPU face au GB300 NVL72 est l’argument central, que NVIDIA qualifie de résultat préliminaire. L’entreprise insiste aussi sur l’échelle, car ajouter des GPU n’aide que s’ils collaborent efficacement.
- Jusqu’à 2x plus de performance par GPU que le GB300 NVL72, selon NVIDIA
- Sur DeepSeek-V3, Vera Rubin NVL72 est passé de 256 à 1 024 GPU avec environ 97 % d’efficacité
- En quadruplant les GPU, le temps d’entraînement est passé de 16 minutes à environ quatre
- NVIDIA a aussi exécuté le test sur 10 240 GPU avec des systèmes GB300, la plus grande échelle de la ronde, et Microsoft Azure a égalé ce chiffre avec 10 240 GPU sur des systèmes GB200
NVIDIA attribue à NVLink la liaison des GPU au sein de chaque système, et à Quantum-X800 InfiniBand et Spectrum-X Ethernet la liaison entre systèmes. Elle ajoute que les performances de Vera Rubin devraient continuer d’augmenter grâce aux optimisations logicielles.
Et l’inférence d’IA agentique ?
MLPerf Endpoints teste des flux de travail de programmation et d’entreprise basés sur des agents, et vérifie que les agents accomplissent bien leurs tâches. La mesure est le nombre de jetons produits par watt, important parce que la puissance limite les centres de données d’IA.
Dans un résultat provisoire pour Kimi K3, un modèle ouvert conçu pour les tâches agentiques, NVIDIA affirme que Vera Rubin NVL72 fournit plus de 10x le débit par watt du GB300 NVL72 à vitesse de réponse égale, comparé à un minimum commun de 50 tokens/sec par utilisateur. L’essai Vera Rubin utilisait 32 accélérateurs pour une puissance de fonctionnement de 100.89 kW, celui du GB300 48 accélérateurs et 60 kW. NVIDIA précise que les chiffres de Vera Rubin attendent la vérification de MLCommons et peuvent changer, alors que ceux du GB300 sont vérifiés.
Combien ça coûte ?
NVIDIA n’indique ni prix ni date de mise en vente pour Vera Rubin NVL72 dans cette annonce. Ce sont des systèmes en baie pour centres de données d’IA : on y accède surtout par un fournisseur infonuagique ou un partenaire. Renseignez-vous directement sur les prix et la disponibilité dans votre pays.
À qui s’adresse-t-il ?
Acheteurs de centres de données et d’infonuagique. L’argument de l’efficacité énergétique est le plus intéressant, puisque la puissance limite le nombre d’agents servis. Les chiffres viennent d’un seul test et d’un seul modèle : demandez des résultats sur votre propre charge.
Développeurs qui louent des GPU. Un entraînement plus rapide raccourcit les cycles d’essai, mais seulement quand un fournisseur offrira Vera Rubin et fixera un prix. Les sources n’indiquent pas de date.
Lecteurs ordinaires. Rien ne change aujourd’hui. Le résultat montre à quelle vitesse de nouvelles fonctions d’IA pourront être entraînées et servies.
Ceux qui devraient attendre. Quiconque prévoit un achat sur la base de ces chiffres. Les résultats Endpoints de Vera Rubin sont provisoires et NVIDIA parle de résultats préliminaires pour l’entraînement.
Que reste-t-il à savoir ?
L’annonce ne précise ni la date de disponibilité, ni le prix, ni la comparaison avec les autres fabricants test par test. MLCommons cite AMD et Google parmi les fabricants d’accélérateurs de la ronde : la page complète des résultats permet de comparer.
Consultez la page de résultats de MLCommons pour les tableaux complets, et les blogues techniques de NVIDIA pour le détail des essais.