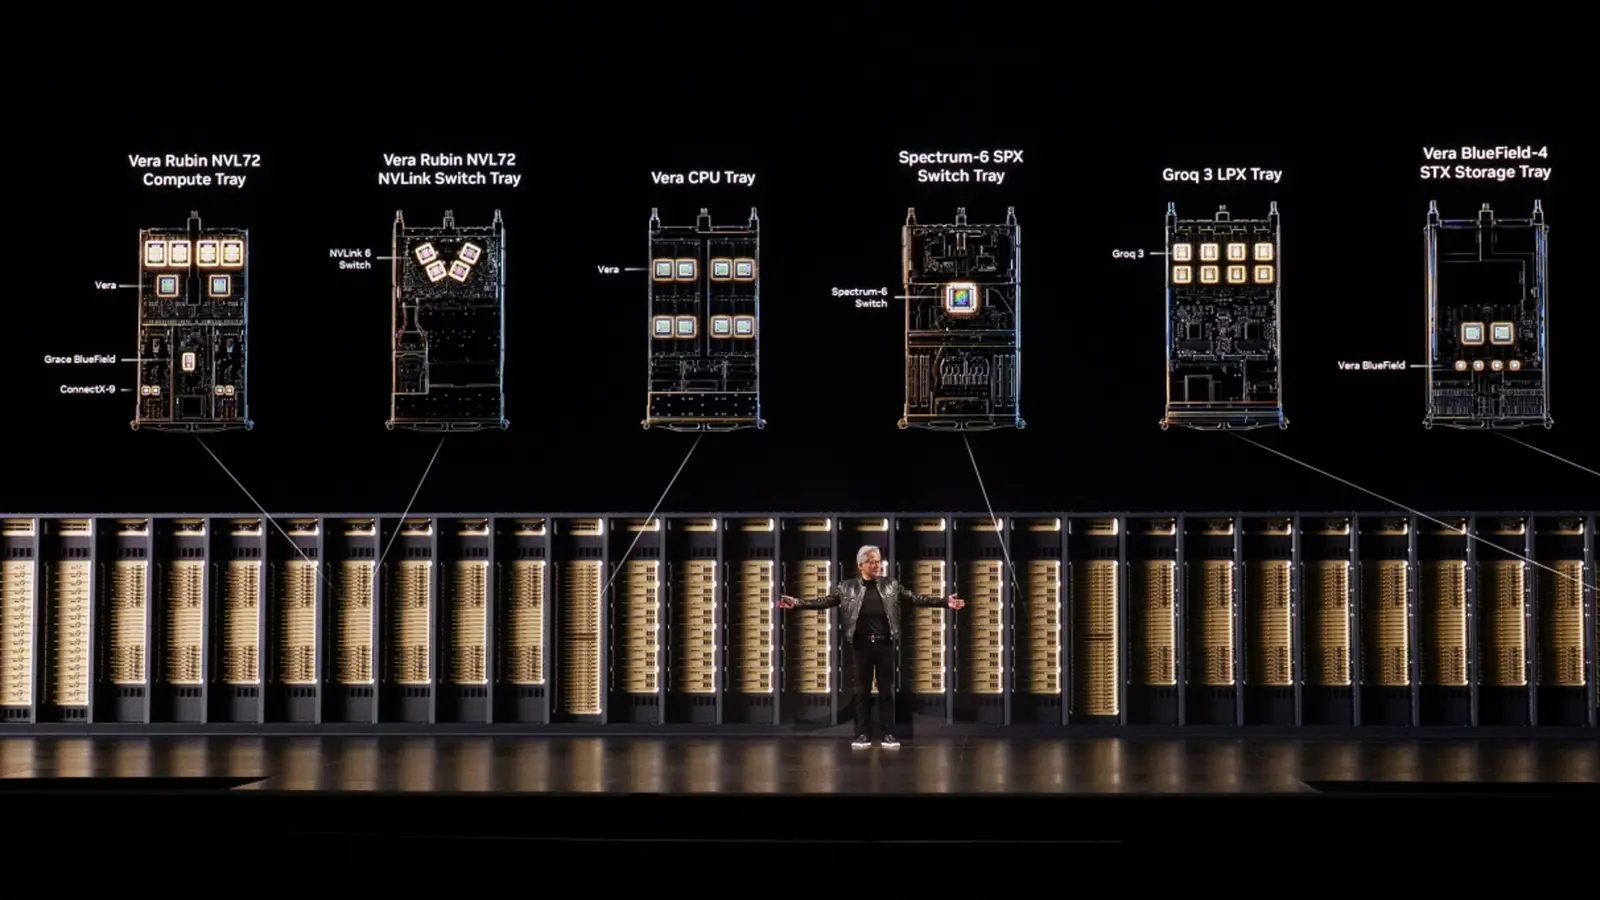
AI 모델을 학습시키는 팀은 GPU가 가동되는 시간만큼 비용을 내기 때문에, 시스템이 빠를수록 비용이 줄고 출시도 앞당겨진다. NVIDIA는 2026년 11월 16일, 새 시스템 Vera Rubin NVL72가 MLCommons가 발표한 MLPerf Training v6.1에서 GPU당 GB300 NVL72보다 최대 2x 높은 성능을 냈다고 밝혔다.
NVIDIA는 이번 라운드의 모든 벤치마크에 결과를 낸 플랫폼이 자사뿐이라고 주장했다. 또 첫 MLPerf Endpoints 제출에서 Vera Rubin이 에이전트형 AI에서 GB300 NVL72의 10x를 넘는 와트당 처리량을 기록했다고 설명했다. 두 시스템 모두 NVIDIA 제품이므로 자사 결과에 대한 회사의 주장이다.
MLPerf Training v6.1은 무엇을 측정했나
MLPerf Training은 시스템이 모델을 목표 정확도까지 학습시키는 데 걸리는 시간을 측정한다. MLCommons에 따르면 이번 라운드에는 24개 기관이 153개 시스템, 250개 결과를 제출했다. 클라우드 시스템은 57개로 전체의 37%였고, 이전 라운드의 29%보다 늘었다. 12개 시스템은 1,000개 이상의 가속기를 썼고 가장 큰 규모는 10,240개였다.
새 벤치마크는 두 가지다. 추천 시스템 테스트인 DLRMv4-HSTU와, 이 제품군 최초의 사후 학습 벤치마크인 Qwen3.5-397B다. NVIDIA는 대규모 언어 모델, 이미지 생성, 추천 시스템, 강화 학습 기반 사후 학습에서 결과를 냈다고 밝혔다.
Vera Rubin은 얼마나 빠른가
핵심 주장은 GB300 NVL72 대비 GPU당 성능 향상으로, NVIDIA는 이를 초기 결과라고 부른다. GPU는 효율적으로 함께 작동해야 늘리는 의미가 있기 때문에 확장성도 강조했다.
- NVIDIA에 따르면 GPU당 성능이 GB300 NVL72보다 최대 2x 높다
- DeepSeek-V3에서 Vera Rubin NVL72는 256개에서 1,024개 GPU로 약 97% 효율로 확장됐다
- GPU 수를 4배로 늘리자 학습 시간이 16분에서 약 4분으로 줄었다
- NVIDIA는 GB300 시스템으로 10,240개 GPU에서도 실행했으며 이는 이번 라운드 최대 규모다. Microsoft Azure도 GB200 시스템의 10,240개 GPU로 같은 규모를 냈다
NVIDIA는 시스템 안의 GPU는 NVLink로, 시스템 사이는 Quantum-X800 InfiniBand와 Spectrum-X Ethernet으로 연결한다고 설명했다. 소프트웨어 최적화로 Vera Rubin 성능이 계속 오를 것이라고도 덧붙였다.
에이전트형 AI 추론은 어떤가
MLPerf Endpoints는 에이전트형 코딩과 기업 업무 흐름으로 시스템을 시험하고, 에이전트가 과제를 제대로 끝내는지도 확인한다. 측정 기준은 전력 1와트당 만들어내는 토큰 수로, AI 데이터센터가 전력에 제약을 받기 때문에 중요하다.
에이전트 작업용 오픈 모델 Kimi K3의 잠정 결과에서 NVIDIA는 Vera Rubin NVL72가 같은 응답 속도에서 GB300 NVL72의 10x를 넘는 와트당 처리량을 냈다고 밝혔다. 비교는 사용자당 최소 50 tokens/sec를 공통 조건으로 했다. Vera Rubin 실행은 가속기 32개에 운영 전력 100.89 kW였고, GB300은 가속기 48개에 60 kW였다. NVIDIA는 Vera Rubin 수치가 MLCommons 검증을 기다리는 중이며 바뀔 수 있고, GB300 결과는 검증을 마쳤다고 덧붙였다.
가격은 얼마인가
이번 발표에는 Vera Rubin NVL72의 가격이나 출시일이 없다. AI 데이터센터용 랙 단위 시스템이라 클라우드 사업자나 시스템 파트너를 통해 쓰는 것이 현실적이다. 가격과 공급 여부는 각 업체에 직접 문의해야 한다.
어떤 사람에게 맞나
데이터센터와 클라우드 구매 담당자. 전력이 처리할 수 있는 에이전트 수를 좌우하므로 전력 효율 주장이 가장 눈여겨볼 대목이다. 수치는 하나의 벤치마크와 하나의 모델에서 나온 것이니 자사 작업 부하의 결과를 요청하는 편이 좋다.
GPU를 빌려 쓰는 AI 개발자. 학습이 빨라지면 실험 주기가 짧아지지만, 사업자가 Vera Rubin을 제공하고 가격을 정한 뒤의 이야기다. 시점은 자료에 없다.
일반 독자. 오늘 달라지는 것은 없다. 새 AI 기능이 얼마나 빨리 학습되고 제공될지 가늠하게 해 주는 결과다.
기다려야 할 사람. 이 수치만 보고 구매를 계획하는 사람이다. Vera Rubin의 Endpoints 수치는 잠정이고 NVIDIA도 학습 결과를 초기 결과라고 말한다.
아직 알려지지 않은 것
발표에는 Vera Rubin NVL72의 공급 시기, 가격, 벤치마크별로 다른 업체와 어떻게 비교되는지가 나와 있지 않다. MLCommons는 AMD와 Google도 이번 라운드의 가속기 업체로 꼽았으므로 전체 결과 페이지에서 비교할 수 있다.
전체 표는 MLCommons 결과 페이지에서, 실행 세부 사항은 NVIDIA의 MLPerf Training 및 Endpoints 기술 블로그에서 볼 수 있다.