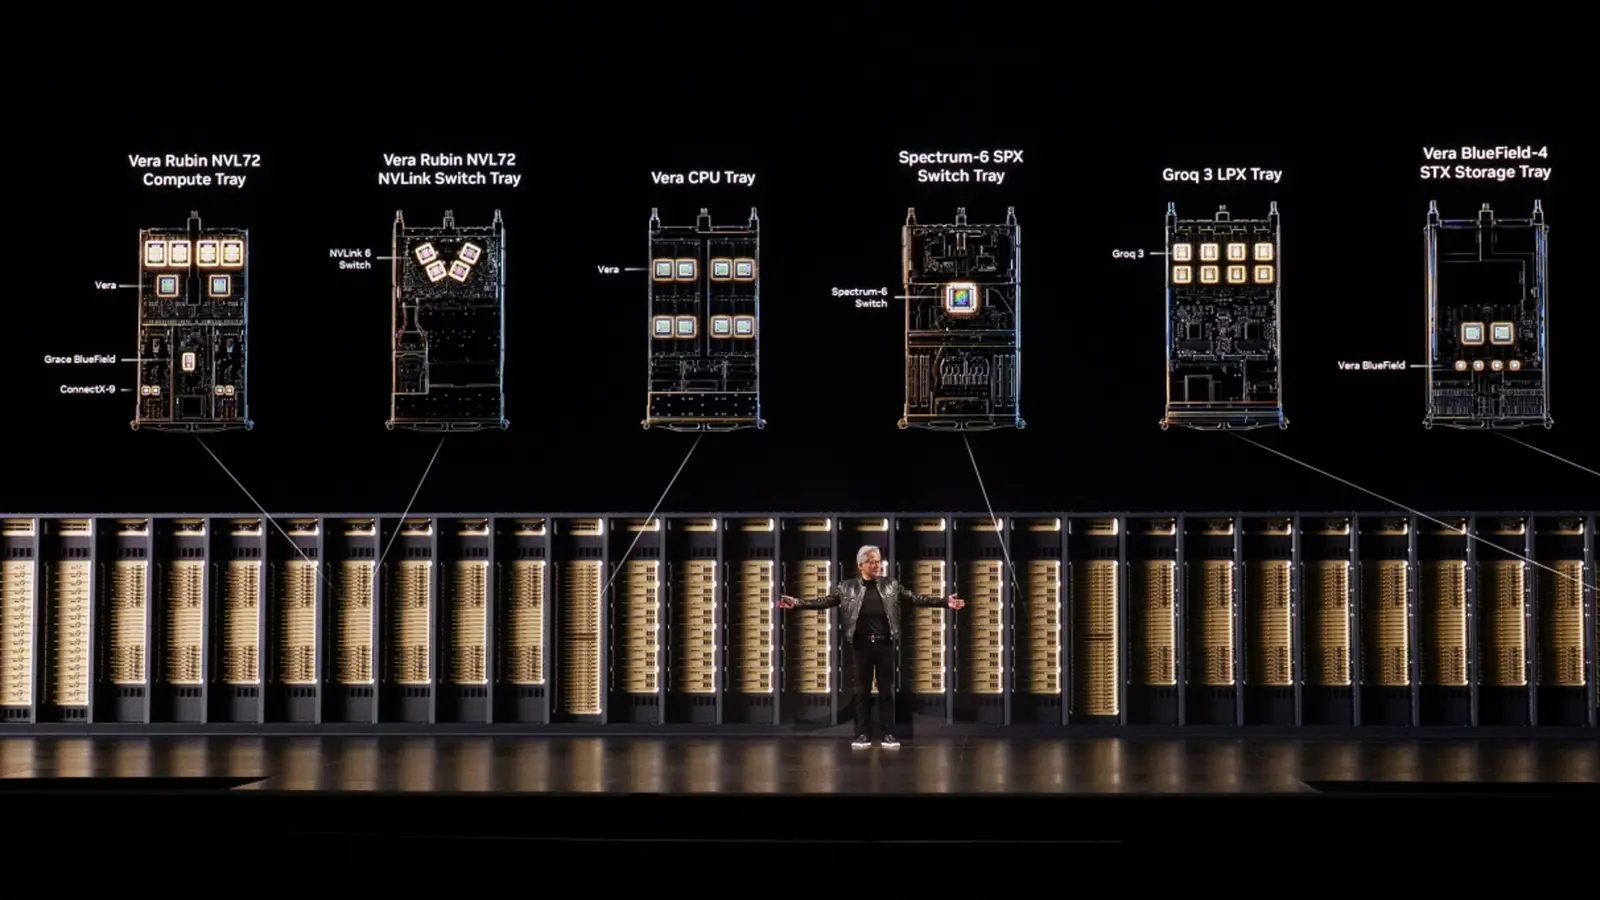
訓練 AI 模型的團隊要為 GPU 運行的每個小時付費,系統愈快,成本愈低,產品也能愈早推出。NVIDIA 於 2026 年 11 月 16 日表示,旗下全新 Vera Rubin NVL72 系統在 MLCommons 公佈的 MLPerf Training v6.1 測試中,每顆 GPU 的效能最多比 GB300 NVL72 高 2x。
NVIDIA 同時指出,它是本輪唯一在所有測試項目都有成績的平台,而且首次參加 MLPerf Endpoints 時,Vera Rubin 在代理式 AI 的每瓦吞吐量超過 GB300 NVL72 的 10x。兩款系統均由 NVIDIA 生產,以上屬該公司對自家成績的說法。
MLPerf Training v6.1 測試甚麼?
MLPerf Training 衡量系統把模型訓練到目標準確度所需的時間。據 MLCommons 表示,本輪共有 24 個機構提交 153 套系統、250 項測試結果。其中 57 套為雲端系統,佔總數 37%,上一輪為 29%。12 套系統使用 1,000 個或以上加速器,最大規模為 10,240 個。
本輪新增兩項測試:推薦系統測試 DLRMv4-HSTU,以及 Qwen3.5-397B,這是測試套件首個後訓練測試。NVIDIA 表示其成績涵蓋大型語言模型、圖像生成、推薦系統和強化學習後訓練。
Vera Rubin 有多快?
最受關注的是相對 GB300 NVL72 的單 GPU 增幅,NVIDIA 稱這是早期成績。公司同時強調擴展能力,因為增加 GPU 只有在它們高效協作時才有用。
- 據 NVIDIA 表示,每顆 GPU 效能最多比 GB300 NVL72 高 2x
- 在 DeepSeek-V3 測試中,Vera Rubin NVL72 由 256 顆擴展至 1,024 顆 GPU,效率約 97%
- GPU 數量增至四倍,訓練時間由 16 分鐘縮短至約四分鐘
- NVIDIA 亦以 GB300 系統在 10,240 顆 GPU 上運行該測試,是本輪最大規模;Microsoft Azure 以 GB200 系統同樣使用 10,240 顆 GPU
NVIDIA 稱,系統內的 GPU 由 NVLink 連接,系統之間則由 Quantum-X800 InfiniBand 和 Spectrum-X Ethernet 連接。公司又指,Vera Rubin 的效能會隨軟件優化而繼續提升。
代理式 AI 推理表現如何?
MLPerf Endpoints 以代理式編程和企業工作流程測試系統,並檢查代理是否正確完成任務。衡量標準是每瓦電力能產生多少 token,由於 AI 數據中心受電力限制,這點相當重要。
在 Kimi K3(一個為代理式工作而設的開放模型)的暫定成績中,NVIDIA 表示 Vera Rubin NVL72 在相同回應速度下,每瓦吞吐量超過 GB300 NVL72 的 10x,比較基準為每名用戶最低 50 tokens/sec。Vera Rubin 的測試使用 32 個加速器,運行功率為 100.89 kW;GB300 的測試使用 48 個加速器和 60 kW。NVIDIA 說明,Vera Rubin 的數字仍待 MLCommons 驗證,可能有變,GB300 的成績則已驗證。
售價是多少?
NVIDIA 在此公佈中沒有列出 Vera Rubin NVL72 的售價或發售日期。這類機櫃級系統是為 AI 數據中心而設,一般透過雲端服務商或系統夥伴使用。請直接向他們查詢所在地區的價格和供應情況。
適合甚麼人?
數據中心及雲端採購人員。 能效數字最值得細看,因為電力限制了可服務的代理數量。數字只來自一項測試和一個模型,建議索取貴公司實際工作負載的成績。
租用 GPU 的 AI 開發者。 訓練更快可縮短試驗週期,但前提是服務商提供 Vera Rubin 並訂價。資料來源沒有交代時間。
一般讀者。 目前沒有任何改變。這個成績反映日後新的 AI 功能可以多快訓練和提供。
應該再等等的人。 打算憑這些數字採購的人。Vera Rubin 的 Endpoints 成績屬暫定,NVIDIA 亦稱訓練成績為早期結果。
還有甚麼未知?
公佈沒有說明 Vera Rubin NVL72 何時供應、售價多少,也沒有逐項比較其他廠商。MLCommons 指 AMD 和 Google 也是本輪的加速器廠商,完整結果頁可供對照。
完整表格請看 MLCommons 結果頁,測試細節則可參閱 NVIDIA 的 MLPerf Training 及 Endpoints 技術網誌。