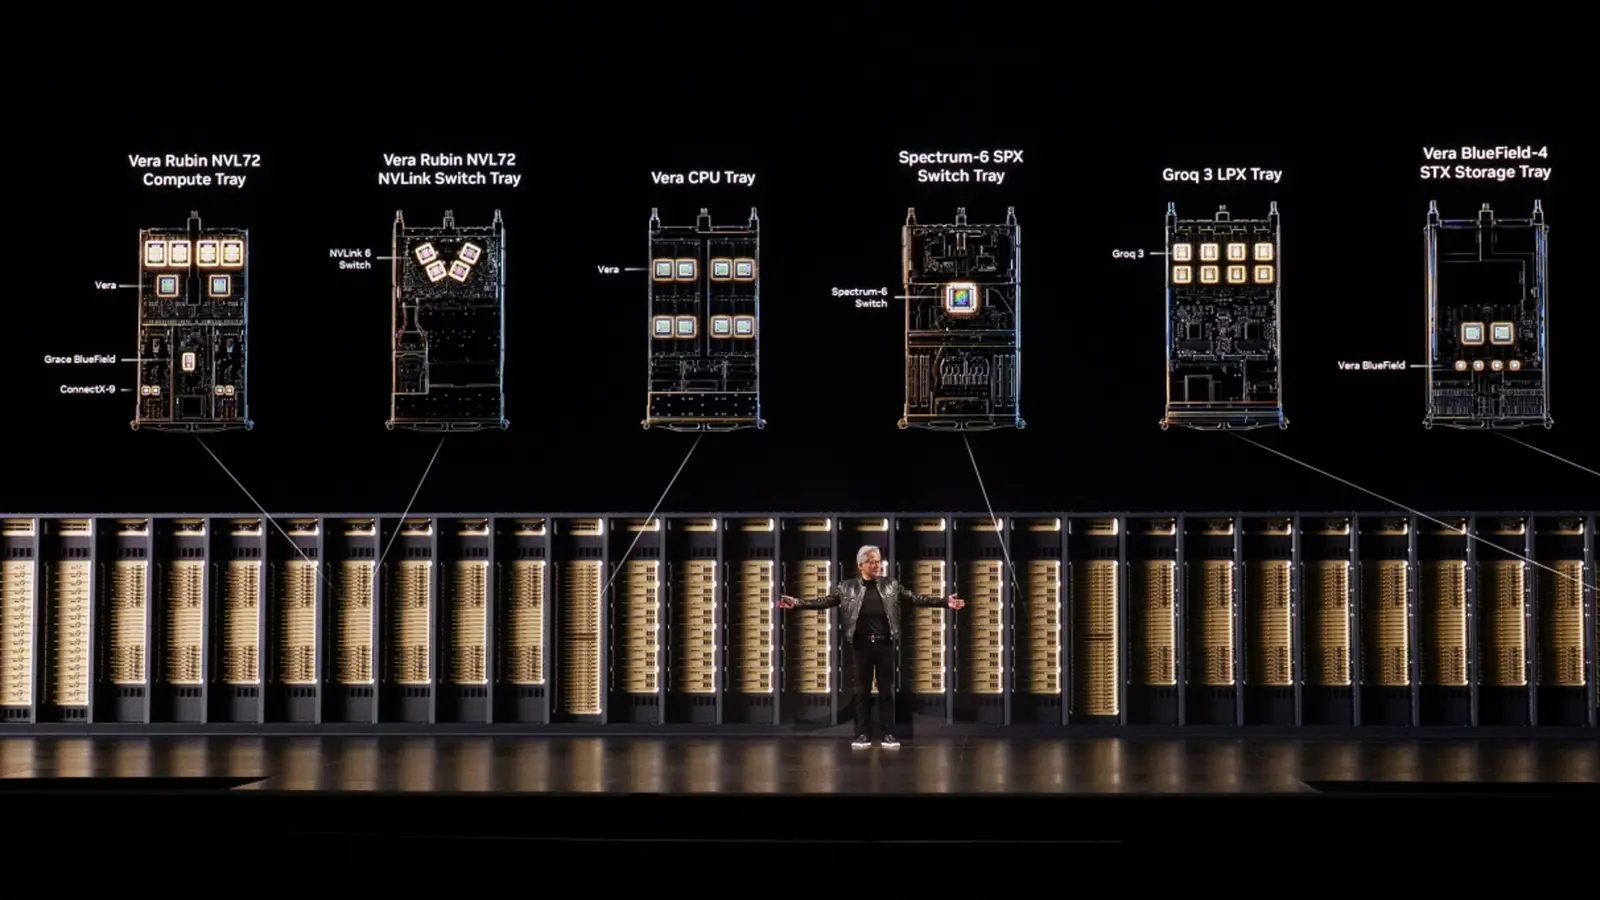
AIモデルを訓練するチームはGPUが動く時間ごとに費用を払うため、システムが速いほど費用は減り、公開も早まる。NVIDIAは2026年11月16日、新システムVera Rubin NVL72が、MLCommonsが公表したMLPerf Training v6.1でGB300 NVL72よりGPUあたり最大2x高い性能を示したと発表した。
NVIDIAはまた、今回のラウンドですべてのベンチマークに結果を出したのは自社のプラットフォームだけだとし、初参加のMLPerf Endpointsでは、エージェント型AIでGB300 NVL72の10xを超えるワット当たりスループットをVera Rubinが出したと説明している。両システムともNVIDIAの製品であり、これは自社の結果についての同社の主張だ。
MLPerf Training v6.1は何を測ったのか
MLPerf Trainingは、モデルを目標の精度まで訓練するのにかかる時間を測る。MLCommonsによると、今回は24団体から153システム、250件の結果が提出された。クラウドのシステムは57で全体の37%を占め、前回の29%から増えた。12システムが1,000基以上のアクセラレーターを使い、最大は10,240基だった。
新たに加わったのは2つのベンチマークだ。推薦モデルのDLRMv4-HSTUと、同スイート初のポストトレーニング向けベンチマークであるQwen3.5-397Bである。NVIDIAは、大規模言語モデル、画像生成、推薦システム、強化学習によるポストトレーニングで結果を出したとしている。
Vera Rubinはどれほど速いのか
中心となる主張はGB300 NVL72に対するGPUあたりの向上で、NVIDIAはこれを初期の結果としている。GPUは効率よく連携して初めて増やす意味があるため、規模の拡張も強調した。
- NVIDIAによると、GPUあたりの性能はGB300 NVL72より最大2x高い
- DeepSeek-V3では、Vera Rubin NVL72が256基から1,024基のGPUへ約97%の効率で拡張した
- GPU数を4倍にすると、訓練時間は16分から約4分に短縮した
- NVIDIAはGB300システムで10,240基のGPUでも実行し、これは今回最大の規模だった。Microsoft AzureもGB200システムの10,240基で並んだ
NVIDIAは、各システム内のGPUはNVLinkで、システム間はQuantum-X800 InfiniBandとSpectrum-X Ethernetでつなぐと説明する。ソフトウェアの最適化でVera Rubinの性能は今後も上がるという。
エージェント型AIの推論はどうか
MLPerf Endpointsは、エージェント型のコーディングや業務ワークフローでシステムを試し、エージェントが正しくタスクを終えるかも確かめる。指標は1ワットあたりに生成できるトークン数で、AIデータセンターは電力に制約されるため重要になる。
エージェント向けのオープンモデルKimi K3の暫定結果で、NVIDIAはVera Rubin NVL72が同じ応答速度でGB300 NVL72の10xを超えるワット当たりスループットを出したという。比較はユーザーあたり最低50 tokens/secを共通条件とした。Vera Rubinの実行は32基のアクセラレーターで稼働電力は100.89 kW、GB300は48基で60 kWだった。NVIDIAは、Vera Rubinの数値はMLCommonsの検証待ちで変わる可能性があり、GB300の結果は検証済みだと注記している。
価格はいくらか
今回の発表にVera Rubin NVL72の価格や発売日の記載はない。AIデータセンター向けのラック規模のシステムであり、利用するならクラウド事業者やシステムパートナー経由が現実的だ。価格と提供状況は各社に直接確認したい。
どんな人に向くか
データセンターやクラウドの調達担当者。 電力が提供できるエージェント数を左右するため、電力効率の主張が最も注目点になる。数値は1つのベンチマークと1つのモデルによるものなので、自社の作業での結果を求めたい。
GPUを借りるAI開発者。 訓練が速くなれば試行の周期は短くなるが、事業者がVera Rubinを提供し価格を付けてからの話だ。時期は資料にない。
一般の読者。 今日は何も変わらない。新しいAI機能がどれだけ早く訓練され提供されるかを占う材料になる。
待つべき人。 この数字だけで購入を決めようとする人。Vera RubinのEndpointsの結果は暫定で、訓練の結果もNVIDIAは初期のものと位置づけている。
まだ分からないこと
発表には、Vera Rubin NVL72の提供時期、価格、他社とのベンチマークごとの比較は示されていない。MLCommonsはAMDとGoogleも今回のアクセラレーターの提供元に挙げており、全結果のページで比較できる。
詳しい表はMLCommonsの結果ページ、実行の詳細はNVIDIAのMLPerf TrainingとEndpointsの技術ブログを参照したい。