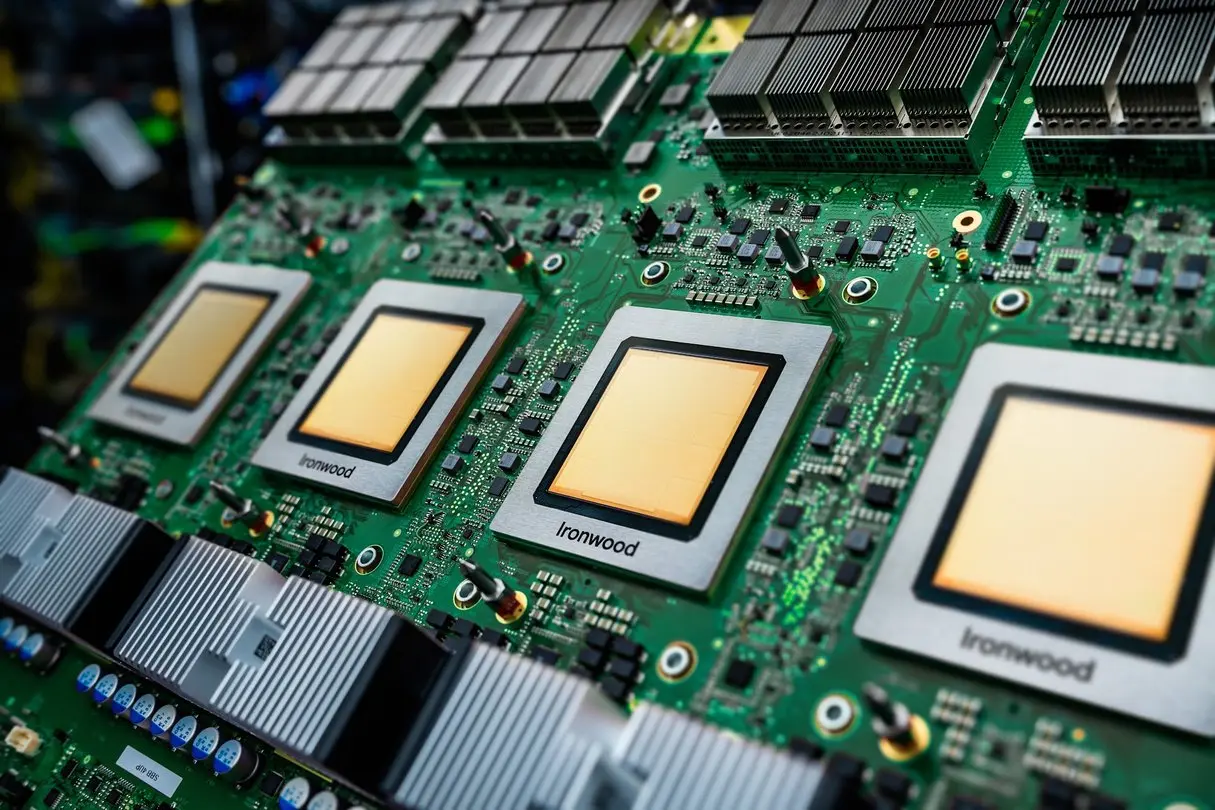
Google Cloudは、第7世代のIronwood TPU 8,192基が、MLPerf Training v6.1の事前学習ベンチマークで1.70分で目標品質に達したと発表した。同社は2026年11月16日にこの結果を公開し、NVIDIA Grace Blackwell GPUでの結果と、初のMLPerfエージェント型強化学習(RL)ベンチマークでの結果も併せて示した。
AIハードウェアを借りる利用者にとって、この数字はGoogleのクラウドが大規模でどこまで動くかを示す。今回Google Cloudが公表した結果は計10件で、いずれもMLCommonsが運営するベンチマークのClosed部門だ。
Google Cloudは何を提出したのか
Googleによると、提出内容は最先端の事前学習とエージェント型RLにまたがり、AI Hypercomputerアーキテクチャ上で動かした。同社は半導体、ネットワーク、オープンソースソフトウェアの協調設計の成果だと説明している。
- Ironwoodでの事前学習:8,192基のIronwood TPUが1.70分で目標品質に到達
- Ironwoodでのエージェント型RL:640基のIronwood TPU
- NVIDIA GB300での事前学習:A4X Maxインスタンスの256基のGPUが31.96分で目標に到達
- NVIDIA GPUでのエージェント型RL:A4XとA4X Maxインスタンスで5件を提出
Googleの脚注の結果一覧によると、事前学習の提出はDeepSeek-V3を2,048基、4,096基、8,192基のIronwoodチップと256基のGB300 GPUで実行した。エージェント型RLはQwen3.5-397Bを、Ironwoodと56基、64基、256基のNVIDIA GPUで動かした。
どれほど拡張できるのか
Googleが強調するのはこの点だ。事前学習は4,096基まで96%の効率で拡張したという。チップは待ち合わせではなく計算に時間を使って初めて、増やすと学習が短くなるため重要である。8,192基での効率は示されておらず、96%は4,096基の実行の数字だ。
参考までに、MLCommonsは今回12システムが1,000基以上のアクセラレーターを使い、最大は10,240基だったとしている。NVIDIAはGB300システムの10,240基GPUでDeepSeek-V3を実行したと報告しており、8,192基のIronwoodは今回の基準で大規模な実行といえる。
エージェント型RLのベンチマークとは
エージェント型RLは、モデルにコードを書かせ、その結果から学ばせて訓練する手法だ。ベンチマークはQwen3.5-397Bで、MLCommonsは同スイート初のポストトレーニング向け負荷と説明し、Group Relative Policy Optimizationでツール呼び出しを含むソフトウェア工学タスクを推論するよう訓練するという。
Googleによると、640基のIronwood TPUがコーディングの目標精度に18.02分で到達し、目標0.69に対して0.765を記録した。コード生成と学習を同時に走らせたため、学習用チップの待ち時間は3%未満だったという。この種の負荷では遊休チップは無駄なコストなので、クラウドの購入者が注意して見るべき数字だ。
価格はいくらか
今回の発表に価格の記載はない。Ironwood TPUとA4X、A4X MaxインスタンスはGoogle Cloudのサービスで、料金と提供状況はリージョンや契約によって異なる。Google Cloudの料金ページか、各国の営業担当に確認したい。
どんな人に向くか
超大型モデルを訓練するチーム。 数千基のTPUを一緒に動かせることが示されており、仕事がそれだけのチップを必要とするなら参考になる。
コーディングエージェントを作るチーム。 チップの遊休が3%未満というRLの結果は、広がりつつある種類の負荷に関わる。1つのベンチマークであり、自分のコードでの保証ではない。
NVIDIAを好む顧客。 GoogleはGB300とGB200のシステムも提出しており、Google Cloud内でその構成を使える。
待つべき人。 この結果だけで事業者を選ぶ人。結果は分類ごとに1モデルで、参照した資料はGoogleを他社と比較していない。
まだ分からないこと
Googleの投稿には価格、地域別の提供状況、TPUとGPUの結果の比較は示されていない。MLCommonsの結果ページには24団体の153システムが載っており、並べて比べられる。MLCommonsはまた、今回がGoogleのTPUv7(Ironwood)とNVIDIAのRubin世代GPUの初結果だとしている。
結果IDはGoogleの投稿で、各提出の比較はMLCommonsのTraining v6.1ページで確認したい。