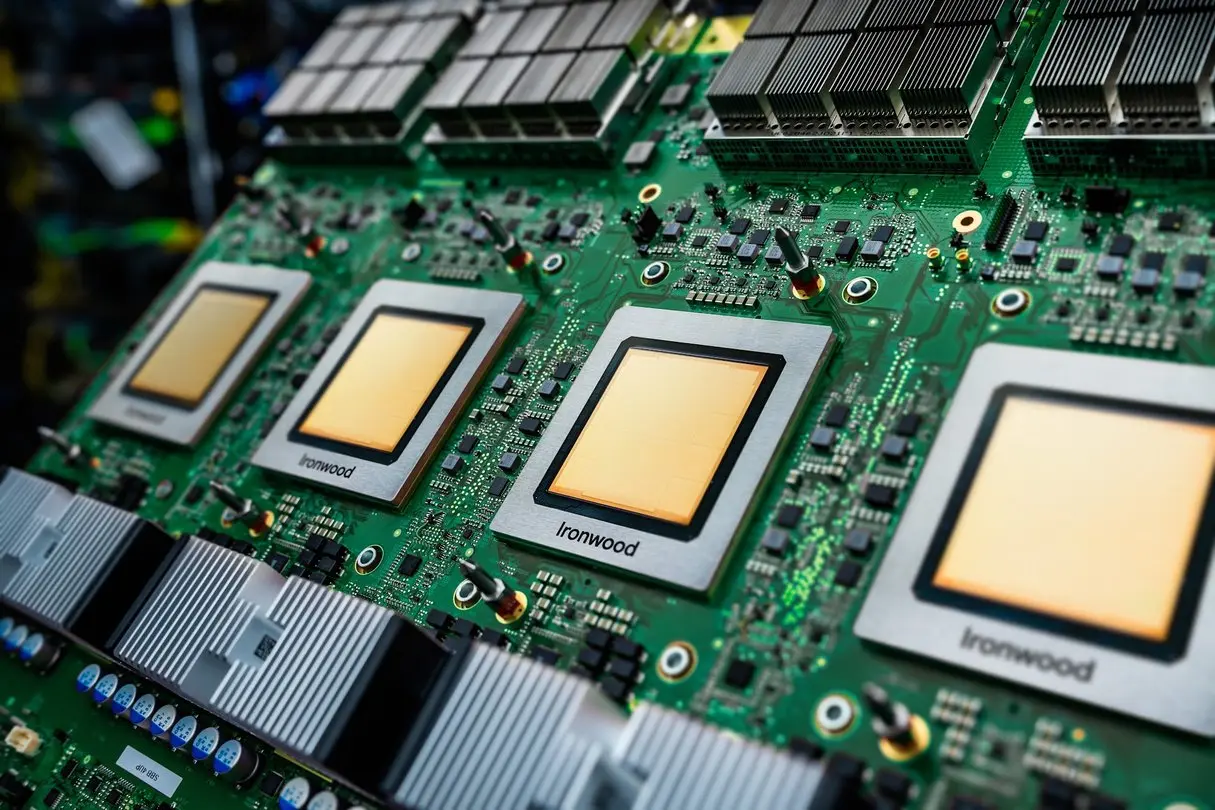
Google Cloud ਦਾ ਕਹਿਣਾ ਹੈ ਕਿ ਉਸ ਦੇ ਸੱਤਵੀਂ ਪੀੜ੍ਹੀ ਦੇ 8,192 Ironwood TPU ਨੇ MLPerf Training v6.1 ਦੇ ਪ੍ਰੀ-ਟ੍ਰੇਨਿੰਗ ਬੈਂਚਮਾਰਕ ਵਿੱਚ 1.70 ਮਿੰਟ ਵਿੱਚ ਟੀਚੇ ਦੀ ਗੁਣਵੱਤਾ ਹਾਸਲ ਕੀਤੀ। ਕੰਪਨੀ ਨੇ ਇਹ ਨਤੀਜਾ 16 ਨਵੰਬਰ 2026 ਨੂੰ ਜਾਰੀ ਕੀਤਾ, ਨਾਲ ਹੀ NVIDIA Grace Blackwell GPU ਦੀਆਂ ਐਂਟਰੀਆਂ ਅਤੇ ਏਜੰਟਿਕ ਰੀਇਨਫੋਰਸਮੈਂਟ ਲਰਨਿੰਗ (RL) ਦੇ ਪਹਿਲੇ MLPerf ਬੈਂਚਮਾਰਕ ਦੇ ਨਤੀਜੇ ਵੀ ਦਿੱਤੇ।
AI ਹਾਰਡਵੇਅਰ ਕਿਰਾਏ ਉੱਤੇ ਲੈਣ ਵਾਲਿਆਂ ਲਈ ਇਹ ਅੰਕੜੇ ਦੱਸਦੇ ਹਨ ਕਿ Google ਦਾ ਕਲਾਊਡ ਵੱਡੇ ਪੈਮਾਨੇ ਉੱਤੇ ਕੀ ਕਰ ਸਕਦਾ ਹੈ। ਇਸ ਦੌਰ ਵਿੱਚ Google Cloud ਨੇ ਕੁੱਲ 10 ਨਤੀਜੇ ਜਾਰੀ ਕੀਤੇ, ਜੋ ਸਾਰੇ MLCommons ਵੱਲੋਂ ਚਲਾਏ ਬੈਂਚਮਾਰਕ ਦੀ Closed ਡਿਵੀਜ਼ਨ ਵਿੱਚ ਹਨ।
Google Cloud ਨੇ ਕੀ ਜਮ੍ਹਾਂ ਕਰਵਾਇਆ?
Google ਮੁਤਾਬਕ ਐਂਟਰੀਆਂ ਅਗਲੀ ਕਤਾਰ ਦੀ ਪ੍ਰੀ-ਟ੍ਰੇਨਿੰਗ ਅਤੇ ਏਜੰਟਿਕ RL ਨੂੰ ਕਵਰ ਕਰਦੀਆਂ ਹਨ ਅਤੇ ਉਸ ਦੇ AI Hypercomputer ਢਾਂਚੇ ਉੱਤੇ ਚੱਲੀਆਂ। ਕੰਪਨੀ ਇਸ ਨੂੰ ਸਿਲੀਕਾਨ, ਨੈੱਟਵਰਕ ਅਤੇ ਓਪਨ ਸਾਫ਼ਟਵੇਅਰ ਦੀ ਸਾਂਝੀ ਡਿਜ਼ਾਈਨ ਦਾ ਨਤੀਜਾ ਦੱਸਦੀ ਹੈ।
- Ironwood ਉੱਤੇ ਪ੍ਰੀ-ਟ੍ਰੇਨਿੰਗ: 8,192 Ironwood TPU ਨੇ 1.70 ਮਿੰਟ ਵਿੱਚ ਟੀਚੇ ਦੀ ਗੁਣਵੱਤਾ ਹਾਸਲ ਕੀਤੀ
- Ironwood ਉੱਤੇ ਏਜੰਟਿਕ RL: 640 Ironwood TPU
- NVIDIA GB300 ਉੱਤੇ ਪ੍ਰੀ-ਟ੍ਰੇਨਿੰਗ: A4X Max ਇੰਸਟੈਂਸਾਂ ਦੇ 256 GPU ਨੇ 31.96 ਮਿੰਟ ਵਿੱਚ ਟੀਚਾ ਪੂਰਾ ਕੀਤਾ
- NVIDIA GPU ਉੱਤੇ ਏਜੰਟਿਕ RL: A4X ਅਤੇ A4X Max ਇੰਸਟੈਂਸਾਂ ਉੱਤੇ ਪੰਜ ਐਂਟਰੀਆਂ
Google ਦੀ ਫ਼ੁੱਟਨੋਟ ਵਿਚਲੀ ਸੂਚੀ ਦੱਸਦੀ ਹੈ ਕਿ ਪ੍ਰੀ-ਟ੍ਰੇਨਿੰਗ ਵਿੱਚ DeepSeek-V3 ਨੂੰ 2,048, 4,096 ਅਤੇ 8,192 Ironwood ਚਿੱਪਾਂ ਅਤੇ 256 GB300 GPU ਉੱਤੇ ਚਲਾਇਆ ਗਿਆ। ਏਜੰਟਿਕ RL ਵਿੱਚ Qwen3.5-397B ਨੂੰ Ironwood ਅਤੇ 56, 64 ਤੇ 256 NVIDIA GPU ਉੱਤੇ ਚਲਾਇਆ ਗਿਆ।
ਇਹ ਕਿੰਨਾ ਫੈਲ ਸਕਦਾ ਹੈ?
Google ਇਸ ਗੱਲ ਉੱਤੇ ਜ਼ੋਰ ਦਿੰਦੀ ਹੈ: ਪ੍ਰੀ-ਟ੍ਰੇਨਿੰਗ 4,096 ਚਿੱਪਾਂ ਤੱਕ 96% ਕੁਸ਼ਲਤਾ ਨਾਲ ਵਧੀ। ਇਹ ਅਹਿਮ ਹੈ ਕਿਉਂਕਿ ਚਿੱਪ ਵਧਾਉਣ ਨਾਲ ਸਿਖਲਾਈ ਤਾਂ ਹੀ ਛੋਟੀ ਹੁੰਦੀ ਹੈ ਜੇ ਉਹ ਇੱਕ ਦੂਜੇ ਦੀ ਉਡੀਕ ਕਰਨ ਦੀ ਥਾਂ ਗਣਨਾ ਕਰਨ। Google ਨੇ 8,192 ਚਿੱਪਾਂ ਦੀ ਕੁਸ਼ਲਤਾ ਨਹੀਂ ਦੱਸੀ, ਇਸ ਲਈ 96% 4,096 ਚਿੱਪਾਂ ਵਾਲੀ ਦੌੜ ਦਾ ਅੰਕੜਾ ਹੈ।
ਹਵਾਲੇ ਲਈ, MLCommons ਮੁਤਾਬਕ ਇਸ ਦੌਰ ਵਿੱਚ 12 ਸਿਸਟਮਾਂ ਨੇ 1,000 ਜਾਂ ਵੱਧ ਐਕਸੀਲੇਰੇਟਰ ਵਰਤੇ ਅਤੇ ਸਭ ਤੋਂ ਵੱਡੇ ਵਿੱਚ 10,240 ਸਨ। NVIDIA ਨੇ GB300 ਸਿਸਟਮਾਂ ਨਾਲ 10,240 GPU ਉੱਤੇ DeepSeek-V3 ਚਲਾਉਣ ਦੀ ਰਿਪੋਰਟ ਦਿੱਤੀ, ਇਸ ਲਈ 8,192 Ironwood ਚਿੱਪ ਇਸ ਦੌਰ ਦੇ ਹਿਸਾਬ ਨਾਲ ਵੱਡੀ ਦੌੜ ਹੈ।
ਏਜੰਟਿਕ RL ਬੈਂਚਮਾਰਕ ਕੀ ਹੈ?
ਏਜੰਟਿਕ RL ਵਿੱਚ ਮਾਡਲ ਨੂੰ ਕੋਡ ਲਿਖਣ ਦਿੱਤਾ ਜਾਂਦਾ ਹੈ ਅਤੇ ਫਿਰ ਨਤੀਜੇ ਤੋਂ ਸਿੱਖਣ ਦਿੱਤਾ ਜਾਂਦਾ ਹੈ। ਬੈਂਚਮਾਰਕ Qwen3.5-397B ਹੈ, ਜਿਸ ਨੂੰ MLCommons ਇਸ ਸੂਟ ਦਾ ਪਹਿਲਾ ਪੋਸਟ-ਟ੍ਰੇਨਿੰਗ ਵਰਕਲੋਡ ਦੱਸਦਾ ਹੈ, ਜਿਸ ਨੂੰ Group Relative Policy Optimization ਨਾਲ ਟੂਲ ਕਾਲਿੰਗ ਸਮੇਤ ਸਾਫ਼ਟਵੇਅਰ ਇੰਜੀਨੀਅਰਿੰਗ ਦੇ ਕੰਮਾਂ ਬਾਰੇ ਸੋਚਣ ਲਈ ਸਿਖਾਇਆ ਜਾਂਦਾ ਹੈ।
Google ਮੁਤਾਬਕ 640 Ironwood TPU ਨੇ ਕੋਡਿੰਗ ਦੀ ਟੀਚਾ ਸ਼ੁੱਧਤਾ 18.02 ਮਿੰਟ ਵਿੱਚ ਹਾਸਲ ਕੀਤੀ, 0.69 ਦੇ ਟੀਚੇ ਦੇ ਮੁਕਾਬਲੇ 0.765 ਅੰਕ ਨਾਲ। ਕੰਪਨੀ ਨੇ ਜੋੜਿਆ ਕਿ ਕੋਡ ਬਣਾਉਣਾ ਅਤੇ ਸਿੱਖਣਾ ਇਕੱਠੇ ਚੱਲੇ, ਇਸ ਲਈ ਸਿਖਲਾਈ ਵਾਲੇ ਚਿੱਪ 3% ਤੋਂ ਘੱਟ ਸਮਾਂ ਉਡੀਕ ਵਿੱਚ ਰਹੇ। ਇਸ ਕਿਸਮ ਦੇ ਕੰਮ ਵਿੱਚ ਵਿਹਲੇ ਚਿੱਪ ਦਾ ਮਤਲਬ ਪੈਸੇ ਦੀ ਬਰਬਾਦੀ ਹੈ, ਇਸ ਲਈ ਕਲਾਊਡ ਖ਼ਰੀਦਦਾਰਾਂ ਨੂੰ ਇਹ ਅੰਕੜਾ ਧਿਆਨ ਨਾਲ ਪੜ੍ਹਨਾ ਚਾਹੀਦਾ ਹੈ।
ਕੀਮਤ ਕੀ ਹੈ?
Google ਨੇ ਇਸ ਐਲਾਨ ਵਿੱਚ ਕੋਈ ਕੀਮਤ ਨਹੀਂ ਦੱਸੀ। Ironwood TPU ਅਤੇ A4X ਤੇ A4X Max ਇੰਸਟੈਂਸ Google Cloud ਦੀਆਂ ਸੇਵਾਵਾਂ ਹਨ, ਇਸ ਲਈ ਕੀਮਤ ਅਤੇ ਉਪਲਬਧਤਾ ਖੇਤਰ ਅਤੇ ਇਕਰਾਰਨਾਮੇ ਉੱਤੇ ਨਿਰਭਰ ਕਰਦੀ ਹੈ। Google Cloud ਦੇ ਕੀਮਤ ਪੰਨੇ ਦੇਖੋ ਜਾਂ ਆਪਣੇ ਦੇਸ਼ ਦੇ ਸੇਲਜ਼ ਸੰਪਰਕ ਤੋਂ ਪੁੱਛੋ।
ਇਹ ਕਿਸ ਲਈ ਹੈ?
ਬਹੁਤ ਵੱਡੇ ਮਾਡਲ ਸਿਖਾਉਣ ਵਾਲੀਆਂ ਟੀਮਾਂ। ਨਤੀਜੇ ਦਿਖਾਉਂਦੇ ਹਨ ਕਿ Google ਹਜ਼ਾਰਾਂ TPU ਨੂੰ ਇਕੱਠੇ ਚਲਾ ਸਕਦਾ ਹੈ, ਜੋ ਤਦ ਕੰਮ ਦਾ ਹੈ ਜਦੋਂ ਤੁਹਾਡੇ ਕੰਮ ਨੂੰ ਇੰਨੇ ਚਿੱਪ ਚਾਹੀਦੇ ਹੋਣ।
ਕੋਡਿੰਗ ਏਜੰਟ ਬਣਾਉਣ ਵਾਲੀਆਂ ਟੀਮਾਂ। 3% ਤੋਂ ਘੱਟ ਵਿਹਲੇ ਸਮੇਂ ਵਾਲਾ RL ਨਤੀਜਾ ਇੱਕ ਵਧ ਰਹੇ ਕਿਸਮ ਦੇ ਕੰਮ ਬਾਰੇ ਹੈ। ਇਹ ਸਿਰਫ਼ ਇੱਕ ਬੈਂਚਮਾਰਕ ਹੈ, ਤੁਹਾਡੇ ਆਪਣੇ ਕੋਡ ਲਈ ਗਾਰੰਟੀ ਨਹੀਂ।
NVIDIA ਪਸੰਦ ਕਰਨ ਵਾਲੇ ਗਾਹਕ। Google ਨੇ GB300 ਅਤੇ GB200 ਸਿਸਟਮ ਵੀ ਜਮ੍ਹਾਂ ਕਰਵਾਏ, ਇਸ ਲਈ ਤੁਸੀਂ Google Cloud ਅੰਦਰ ਉਸੇ ਸਟੈਕ ਉੱਤੇ ਰਹਿ ਸਕਦੇ ਹੋ।
ਜਿਨ੍ਹਾਂ ਨੂੰ ਉਡੀਕ ਕਰਨੀ ਚਾਹੀਦੀ ਹੈ। ਜੋ ਸਿਰਫ਼ ਇਨ੍ਹਾਂ ਨਤੀਜਿਆਂ ਤੋਂ ਪ੍ਰਦਾਤਾ ਚੁਣ ਰਹੇ ਹਨ। ਇਹ ਹਰ ਸ਼੍ਰੇਣੀ ਵਿੱਚ ਇੱਕ ਮਾਡਲ ਦਿਖਾਉਂਦੇ ਹਨ ਅਤੇ ਇੱਥੋਂ ਦੇ ਸਰੋਤ Google ਦੀ ਹੋਰ ਕੰਪਨੀਆਂ ਨਾਲ ਤੁਲਨਾ ਨਹੀਂ ਕਰਦੇ।
ਅਜੇ ਕੀ ਪਤਾ ਨਹੀਂ?
Google ਦੀ ਪੋਸਟ ਵਿੱਚ ਕੀਮਤਾਂ, ਖੇਤਰ ਅਨੁਸਾਰ ਉਪਲਬਧਤਾ ਜਾਂ TPU ਅਤੇ GPU ਐਂਟਰੀਆਂ ਦੀ ਆਪਸੀ ਤੁਲਨਾ ਨਹੀਂ ਹੈ। MLCommons ਦੇ ਨਤੀਜਾ ਪੰਨੇ ਉੱਤੇ 24 ਸੰਸਥਾਵਾਂ ਦੇ 153 ਸਿਸਟਮ ਹਨ, ਇਸ ਲਈ ਤੁਲਨਾ ਉੱਥੇ ਹੋ ਸਕਦੀ ਹੈ। MLCommons ਇਹ ਵੀ ਕਹਿੰਦਾ ਹੈ ਕਿ ਇਸ ਦੌਰ ਵਿੱਚ Google TPUv7 (Ironwood) ਅਤੇ NVIDIA Rubin ਪੀੜ੍ਹੀ ਦੇ GPU ਦੇ ਪਹਿਲੇ ਨਤੀਜੇ ਆਏ।
ਨਤੀਜਿਆਂ ਦੇ ਪਛਾਣ ਨੰਬਰ ਲਈ Google ਦੀ ਪੋਸਟ ਅਤੇ ਐਂਟਰੀਆਂ ਦੀ ਤੁਲਨਾ ਲਈ MLCommons ਦਾ Training v6.1 ਪੰਨਾ ਪੜ੍ਹੋ।