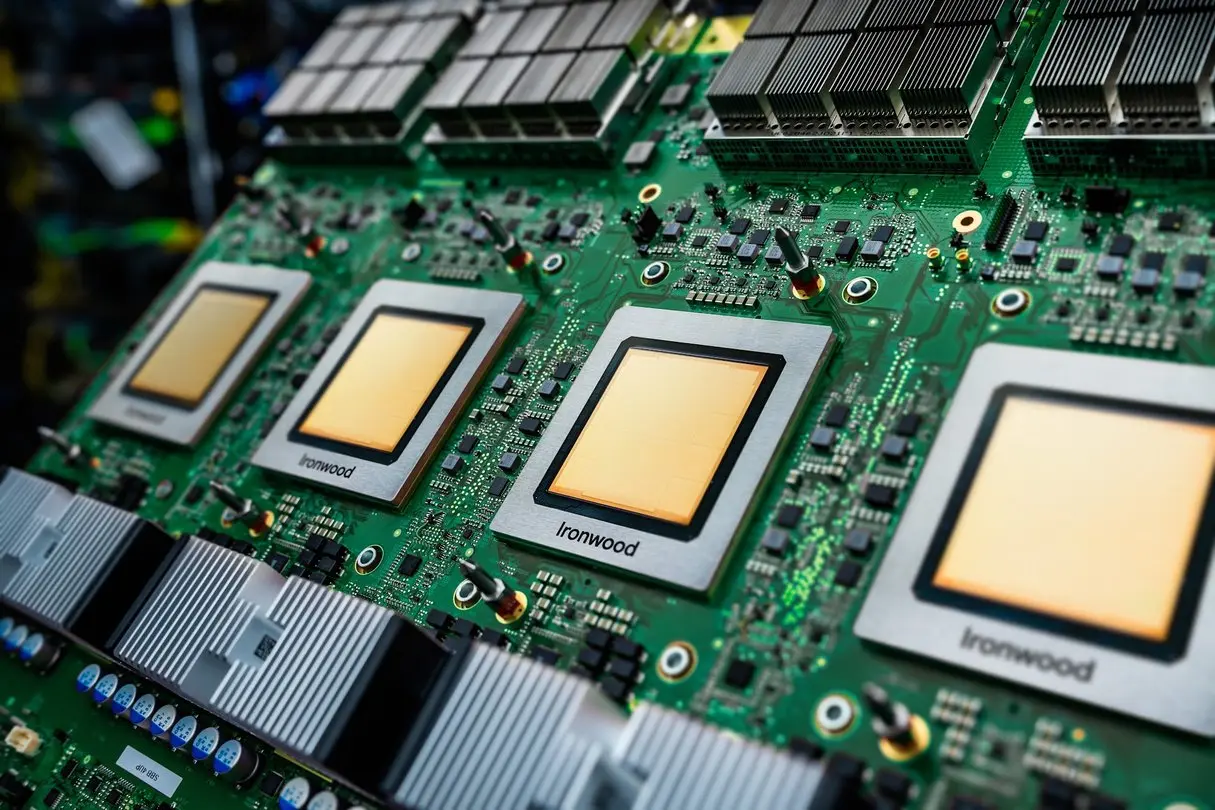
Google Cloud affirme que 8 192 de ses TPU Ironwood de septième génération ont atteint la qualité cible du test de pré-entraînement de MLPerf Training v6.1 en 1.70 minutes. L’entreprise a publié ce résultat le 16 novembre 2026, avec des essais sur des GPU NVIDIA Grace Blackwell et sur le premier test MLPerf d’apprentissage par renforcement (RL) agentique.
Pour qui loue du matériel d’IA, ces chiffres montrent ce que le nuage de Google peut faire à grande échelle. Au total, Google Cloud a publié 10 résultats dans cette ronde, tous dans la division Closed du test géré par MLCommons.
Qu’a soumis Google Cloud ?
Google indique que les essais couvrent le pré-entraînement de pointe et le RL agentique, sur son architecture AI Hypercomputer. L’entreprise parle de conception conjointe du silicium, du réseau et des logiciels ouverts.
- Pré-entraînement sur Ironwood : 8 192 TPU Ironwood ont atteint la qualité cible en 1.70 minutes
- RL agentique sur Ironwood : 640 TPU Ironwood
- Pré-entraînement sur NVIDIA GB300 : 256 GPU sur des instances A4X Max ont atteint la cible en 31.96 minutes
- RL agentique sur GPU NVIDIA : cinq soumissions sur des instances A4X et A4X Max
La liste des résultats en note de Google montre que le pré-entraînement a utilisé DeepSeek-V3 sur 2 048, 4 096 et 8 192 puces Ironwood, ainsi que sur 256 GPU GB300. Le RL agentique a utilisé Qwen3.5-397B sur Ironwood et sur 56, 64 et 256 GPU NVIDIA.
Comment cela passe-t-il à l’échelle ?
Google insiste sur ce point : le pré-entraînement a atteint 4 096 puces avec 96 % d’efficacité. C’est important, car ajouter des puces ne raccourcit l’entraînement que si elles calculent au lieu de s’attendre. Google ne donne pas l’efficacité à 8 192 puces : les 96 % concernent l’essai à 4 096 puces.
À titre de comparaison, MLCommons indique que 12 systèmes de cette ronde ont utilisé 1 000 accélérateurs ou plus, et que le plus grand en comptait 10 240. NVIDIA a présenté un essai DeepSeek-V3 sur 10 240 GPU GB300, ce qui fait de 8 192 puces Ironwood une grande exécution pour cette ronde.
Qu’est-ce que le test de RL agentique ?
Le RL agentique entraîne un modèle en le laissant écrire du code puis apprendre du résultat. Le test est Qwen3.5-397B, que MLCommons décrit comme la première charge de post-entraînement de la suite, entraînée avec Group Relative Policy Optimization à raisonner sur des tâches de génie logiciel, y compris l’appel d’outils.
Google dit que 640 TPU Ironwood ont atteint la précision cible en programmation en 18.02 minutes, avec 0.765 contre un objectif de 0.69. La génération de code et l’apprentissage se déroulaient en même temps, de sorte que les puces d’entraînement ont attendu moins de 3 % du temps. Des puces inactives coûtent cher : c’est le chiffre à lire de près pour les acheteurs.
Combien ça coûte ?
Google n’indique aucun prix dans cette annonce. Les TPU Ironwood et les instances A4X et A4X Max sont des services Google Cloud : tarifs et disponibilité dépendent de la région et du contrat. Consultez les pages de tarification de Google Cloud ou un représentant dans votre pays.
À qui s’adresse-t-il ?
Équipes qui entraînent de très grands modèles. Les résultats montrent que Google fait fonctionner des milliers de TPU ensemble, utile si votre tâche exige autant de puces.
Équipes qui bâtissent des agents de programmation. Le résultat RL, avec des puces inactives moins de 3 % du temps, concerne une charge de plus en plus répandue. Il s’agit d’un seul test, pas d’une garantie pour votre code.
Clients qui préfèrent NVIDIA. Google a aussi soumis des systèmes GB300 et GB200, vous pouvez donc rester sur cette pile dans Google Cloud.
Ceux qui devraient attendre. Quiconque choisit un fournisseur sur ces seuls résultats. Ils montrent un modèle par catégorie et les sources ne comparent pas Google aux autres fabricants.
Que reste-t-il à savoir ?
L’article de Google ne donne ni prix, ni disponibilité régionale, ni comparaison entre TPU et GPU. La page de MLCommons recense 153 systèmes de 24 organisations : c’est là qu’on compare. MLCommons ajoute que cette ronde apporte les premiers résultats des TPUv7 (Ironwood) de Google et des GPU de génération Rubin de NVIDIA.
Lisez l’article de Google pour les identifiants de résultats, et la page MLCommons Training v6.1 pour comparer les soumissions.