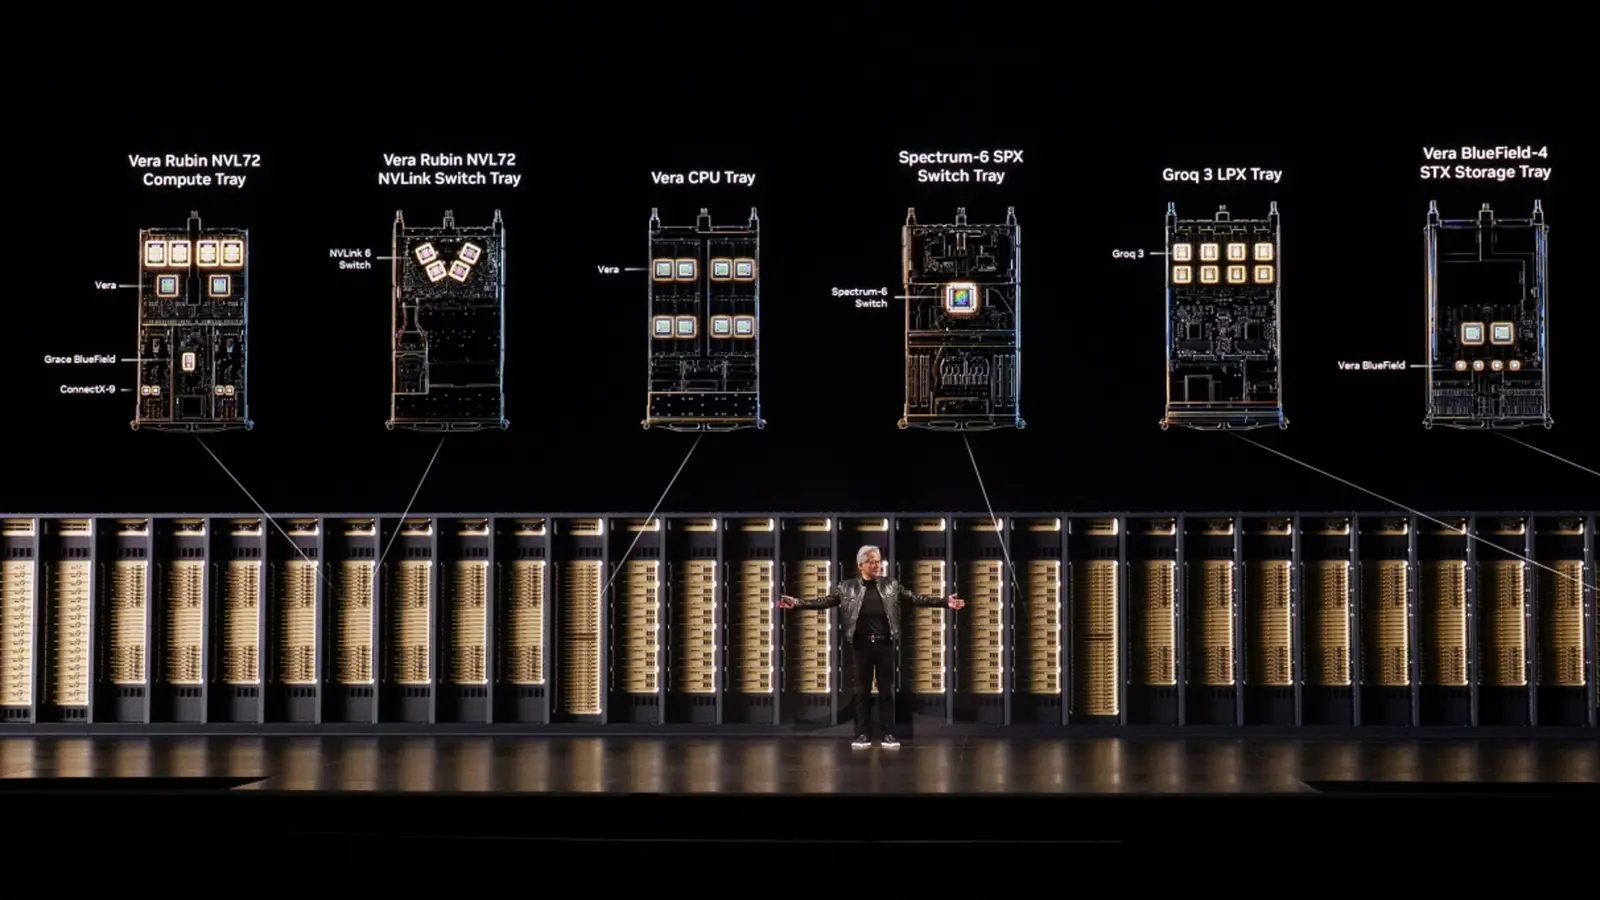
Các nhóm huấn luyện mô hình AI phải trả tiền cho từng giờ GPU hoạt động, nên hệ thống nhanh hơn đồng nghĩa hóa đơn nhỏ hơn và ra mắt sớm hơn. Ngày 16 tháng 11 năm 2026, NVIDIA cho biết hệ thống Vera Rubin NVL72 mới đạt hiệu năng mỗi GPU cao hơn tới 2x so với GB300 NVL72 trong MLPerf Training v6.1, vòng đánh giá do MLCommons công bố.
NVIDIA cũng nói đây là nền tảng duy nhất có kết quả ở mọi bài kiểm tra của vòng này, và trong lần đầu nộp kết quả MLPerf Endpoints, Vera Rubin đạt thông lượng trên mỗi watt cho AI tác tử cao hơn hơn 10x so với GB300 NVL72. NVIDIA sản xuất cả hai hệ thống, nên đây là tuyên bố của chính hãng về kết quả của mình.
MLPerf Training v6.1 đã kiểm tra những gì?
MLPerf Training đo tốc độ một hệ thống huấn luyện mô hình đến mức chính xác mục tiêu. Theo MLCommons, vòng này có 153 hệ thống và 250 kết quả từ 24 tổ chức. Hệ thống đám mây chiếm 57, tức 37% tổng số, tăng từ 29% ở vòng trước. 12 hệ thống dùng từ 1.000 bộ tăng tốc trở lên, và hệ thống lớn nhất dùng 10.240.
Có hai bài kiểm tra mới: DLRMv4-HSTU cho hệ thống gợi ý, và Qwen3.5-397B, bài kiểm tra hậu huấn luyện đầu tiên của bộ. NVIDIA cho biết kết quả của hãng bao gồm mô hình ngôn ngữ lớn, tạo ảnh, hệ thống gợi ý và hậu huấn luyện bằng học tăng cường.
Vera Rubin nhanh đến mức nào?
Tuyên bố chính là mức tăng trên mỗi GPU so với GB300 NVL72, mà NVIDIA gọi là kết quả ban đầu. Hãng cũng nhấn mạnh khả năng mở rộng, vì thêm GPU chỉ có ích khi chúng phối hợp hiệu quả.
- Hiệu năng mỗi GPU cao hơn tới 2x so với GB300 NVL72, theo NVIDIA
- Ở bài DeepSeek-V3, Vera Rubin NVL72 mở rộng từ 256 lên 1.024 GPU với hiệu suất khoảng 97%
- Tăng gấp bốn số GPU làm thời gian huấn luyện giảm từ 16 phút xuống khoảng bốn phút
- NVIDIA cũng chạy bài kiểm tra trên 10.240 GPU với hệ thống GB300, quy mô lớn nhất vòng này, và Microsoft Azure đạt cùng quy mô với 10.240 GPU trên hệ thống GB200
NVIDIA cho biết NVLink nối các GPU trong mỗi hệ thống, còn Quantum-X800 InfiniBand và Spectrum-X Ethernet nối các hệ thống với nhau. Hãng nói hiệu năng Vera Rubin sẽ còn tăng nhờ tối ưu phần mềm.
Còn suy luận AI tác tử thì sao?
MLPerf Endpoints thử hệ thống bằng các tác vụ lập trình và quy trình doanh nghiệp theo kiểu tác tử, đồng thời kiểm tra tác tử có hoàn thành đúng việc hay không. Thước đo là số token tạo ra trên mỗi watt, quan trọng vì các trung tâm dữ liệu AI bị giới hạn bởi điện năng.
Trong kết quả tạm thời với Kimi K3, một mô hình mở cho công việc tác tử, NVIDIA cho biết Vera Rubin NVL72 đạt thông lượng trên mỗi watt cao hơn hơn 10x so với GB300 NVL72 ở cùng tốc độ phản hồi, so sánh ở mức chung tối thiểu 50 tokens/sec mỗi người dùng. Lượt chạy của Vera Rubin dùng 32 bộ tăng tốc với công suất hoạt động 100.89 kW, còn GB300 dùng 48 bộ tăng tốc và 60 kW. NVIDIA lưu ý số liệu Vera Rubin đang chờ MLCommons xác minh và có thể thay đổi, trong khi kết quả GB300 đã được xác minh.
Giá bao nhiêu?
Thông báo này của NVIDIA không nêu giá hay ngày bán của Vera Rubin NVL72. Đây là hệ thống cấp tủ rack cho trung tâm dữ liệu AI, nên cách thực tế để dùng là qua nhà cung cấp đám mây hoặc đối tác hệ thống. Hãy hỏi trực tiếp họ về giá và khả năng cung cấp tại nước bạn.
Phù hợp với ai?
Người mua cho trung tâm dữ liệu và đám mây. Tuyên bố về hiệu quả điện năng đáng chú ý nhất, vì điện quyết định số tác tử có thể phục vụ. Số liệu đến từ một bài kiểm tra và một mô hình, nên hãy xin kết quả trên khối lượng công việc của bạn.
Nhà phát triển AI thuê GPU. Huấn luyện nhanh hơn rút ngắn chu kỳ thử nghiệm, nhưng chỉ khi nhà cung cấp triển khai Vera Rubin và định giá. Các nguồn tin không nêu thời điểm.
Độc giả phổ thông. Hôm nay chưa có gì thay đổi. Kết quả cho thấy các tính năng AI mới có thể được huấn luyện và phục vụ nhanh đến đâu.
Người nên chờ. Ai định mua dựa trên các con số này. Số liệu Endpoints của Vera Rubin là tạm thời và NVIDIA gọi kết quả huấn luyện là ban đầu.
Điều gì vẫn chưa rõ?
Thông báo không nói khi nào Vera Rubin NVL72 đến tay khách hàng, giá bao nhiêu, hay so với các hãng khác ở từng bài kiểm tra ra sao. MLCommons liệt kê AMD và Google trong số các hãng bộ tăng tốc của vòng này, nên trang kết quả đầy đủ là nơi để so sánh.
Hãy đọc trang kết quả của MLCommons để xem bảng đầy đủ, và các blog kỹ thuật MLPerf Training và Endpoints của NVIDIA để biết chi tiết các lượt chạy.