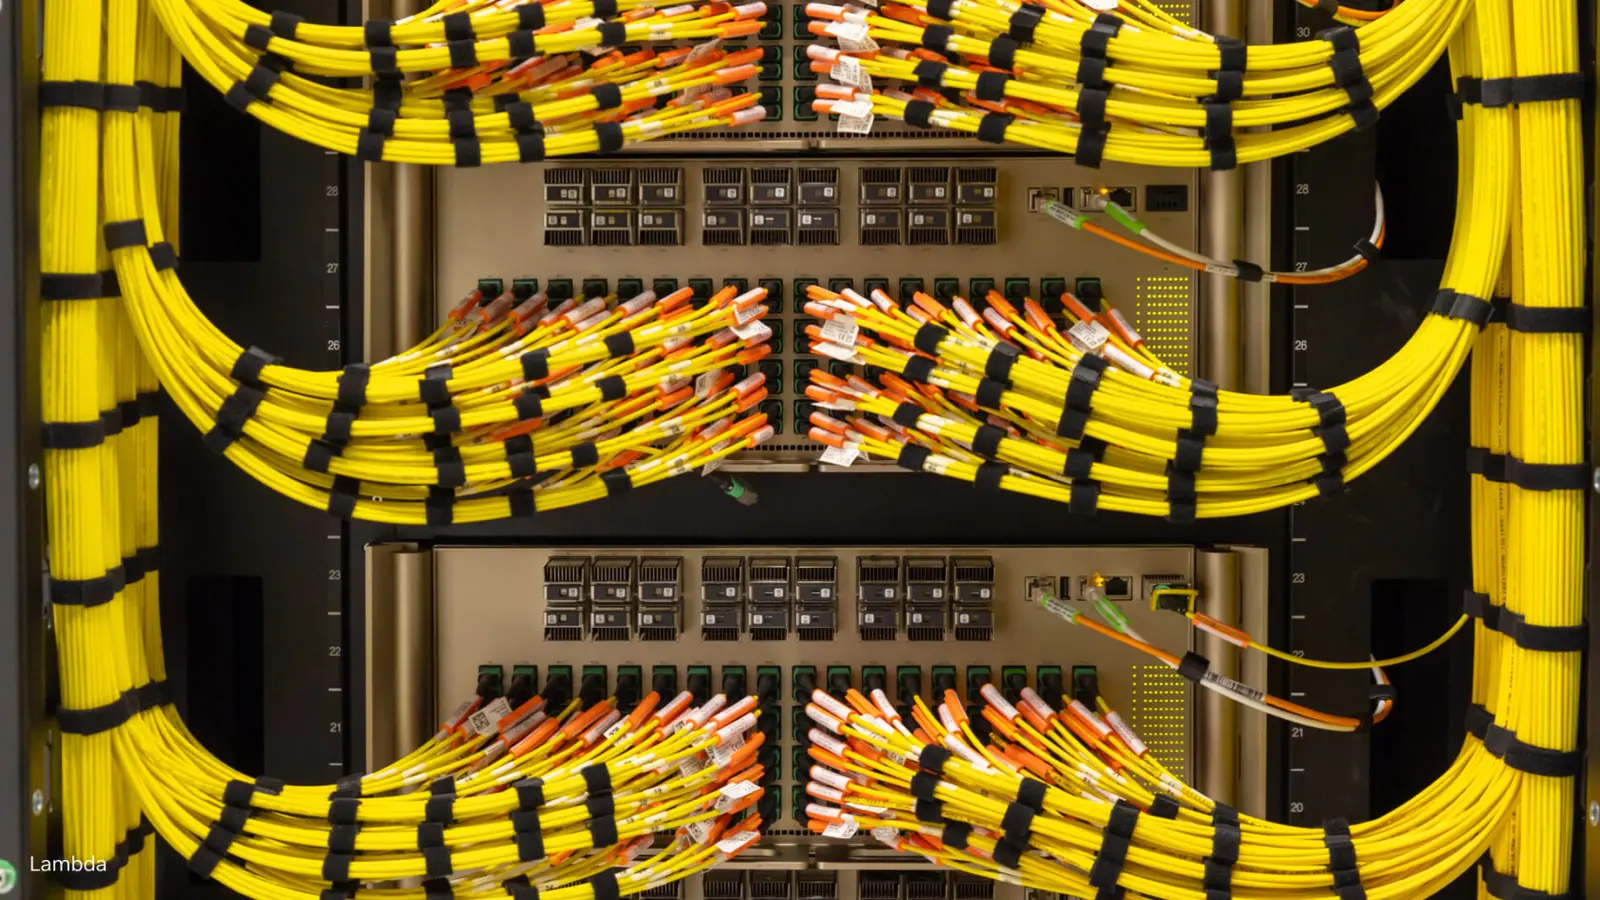
Le fournisseur infonuagique Lambda utilise les commutateurs NVIDIA Photonics à optique co-intégrée (CPO) pour relier des racks NVIDIA GB300 NVL72 regroupant plus de 10 000 GPU. NVIDIA affirme que cette conception réduit la consommation d’énergie, améliore la résilience et allonge le temps moyen entre interruptions du réseau d’une usine d’IA. NVIDIA a publié les détails le 16 novembre 2026, dans le cadre de ses annonces du SC26.
Le réseau est la partie d’une grappe d’IA que l’on voit rarement. Pour entraîner un modèle, des milliers de GPU doivent travailler ensemble, et les liens qui les unissent doivent être rapides, efficaces et résilients. Selon NVIDIA, un seul lien interrompu dans un grand entraînement peut bloquer des milliers de GPU.
Qu’est-ce que Lambda a mesuré ?
NVIDIA indique que les essais de Lambda montrent trois choses :
- La latence réseau a baissé d’environ 4 % à l’échelle d’un rack et jusqu’à environ 10 % à l’échelle d’un pod.
- Le débit est resté identique à celui de l’optique enfichable classique pour les configurations rack, unité évolutive et pod.
- Lambda rapporte une température médiane des optiques de 36°C, contre 51°C pour l’optique enfichable classique, avec une intégrité du signal plus stable.
Dave Ward, président des services infonuagiques chez Lambda, a déclaré : « Le réseau doit suivre les exigences de grappes d’IA toujours plus grandes. »
Comment fonctionnent ces commutateurs ?
Au lieu de brancher un émetteur-récepteur dans chaque port, la co-intégration place les moteurs optiques à côté de la puce du commutateur, dans le même boîtier. NVIDIA affirme que ce remplacement offre jusqu’à 5x plus d’efficacité énergétique et jusqu’à 15x plus de fiabilité que l’optique enfichable classique, avec 4x moins de lasers, donc moins de pièces susceptibles de tomber en panne.
Les détails fournis par NVIDIA pour le déploiement de Lambda :
- Chaque commutateur compte 144 ports à 800Gb/s.
- Un refroidissement liquide évacue la chaleur de la puce et des moteurs optiques.
- Chaque commutateur dispose de 18 sources lumineuses externes amovibles, que les techniciens peuvent remplacer sur place, sans changer un module complet quand un laser tombe en panne.
- La co-intégration réduit le trajet électrique de quelques pouces à quelques millimètres et supprime les puces de resynchronisation, ce qui diminue la consommation et le nombre de pièces sur le trajet du signal.
Que disent les chiffres de Lambda sur la consommation ?
Lambda a décrit le 1er juin 2026 un échantillon d’ingénierie d’un commutateur NVIDIA Quantum-X Photonics, le Q3450-LD : un appareil 4U offrant 115,2 Tb/s de capacité non bloquante, avec les mêmes 144 ports à 800G et 18 modules de source lumineuse amovibles.
Lambda indique une consommation de 3,95 kW, contre 7,0 kW pour un commutateur standard, soit 3,05 kW économisés par commutateur. Pour une grappe GB300 NVL72 de 10 368 GPU, l’entreprise compte 216 commutateurs CPO et 658 kW d’énergie réseau libérée, l’équivalent de 470 GPU supplémentaires.
Lambda ajoute une réserve : le CPO n’augmente pas automatiquement le nombre de GPU déployables, car la disposition des racks, le refroidissement et la distribution électrique déterminent l’usage de ces watts. L’entreprise précise aussi qu’un centre de données de 128 000 GPU avec des émetteurs-récepteurs enfichables traditionnels exige environ 655 000 modules, chacun étant un point de défaillance possible, et que le réseau dorsal représente 86 % de la consommation réseau dans une grappe à trois niveaux à cette échelle.
Combien ça coûte ?
Ni l’article de NVIDIA ni celui de Lambda n’indiquent de prix pour les commutateurs ou pour la capacité GPU de Lambda. Le prix et la disponibilité sont à demander directement à NVIDIA et à Lambda.
À qui s’adresse cette annonce ?
Aux responsables d’infrastructures d’IA et de centres de données. Les chiffres de consommation, de température et de fiabilité sont l’essentiel : ils montrent ce que coûte la couche réseau en watts et en interruptions à plus de 10 000 GPU.
Aux équipes qui louent de la capacité GPU. Lambda est un fournisseur infonuagique, et moins d’interruptions réseau importent surtout pour les longs travaux. Les sources ne disent pas si les clients verront un changement de service ou de prix.
Aux exploitants de grappes bien plus petites. Les chiffres viennent d’un déploiement de plus de 10 000 GPU et ne valent pas promesse pour quelques racks.
À ceux qui veulent des mesures indépendantes. Toutes les mesures ci-dessus viennent de NVIDIA ou de Lambda. Aucune source ne rapporte d’essai externe : ces pourcentages sont fournis par les fabricants.
Que reste-t-il à préciser ?
Les sources ne nomment pas le site, n’indiquent pas combien de clients de Lambda utilisent la grappe et ne donnent pas de date de disponibilité générale des commutateurs. NVIDIA et Lambda ne publient pas non plus de chiffre de consommation pour ce déploiement précis.
Pour le détail technique, lisez l’article de NVIDIA sur le déploiement de Lambda et la description du commutateur Quantum-X Photonics publiée par Lambda.