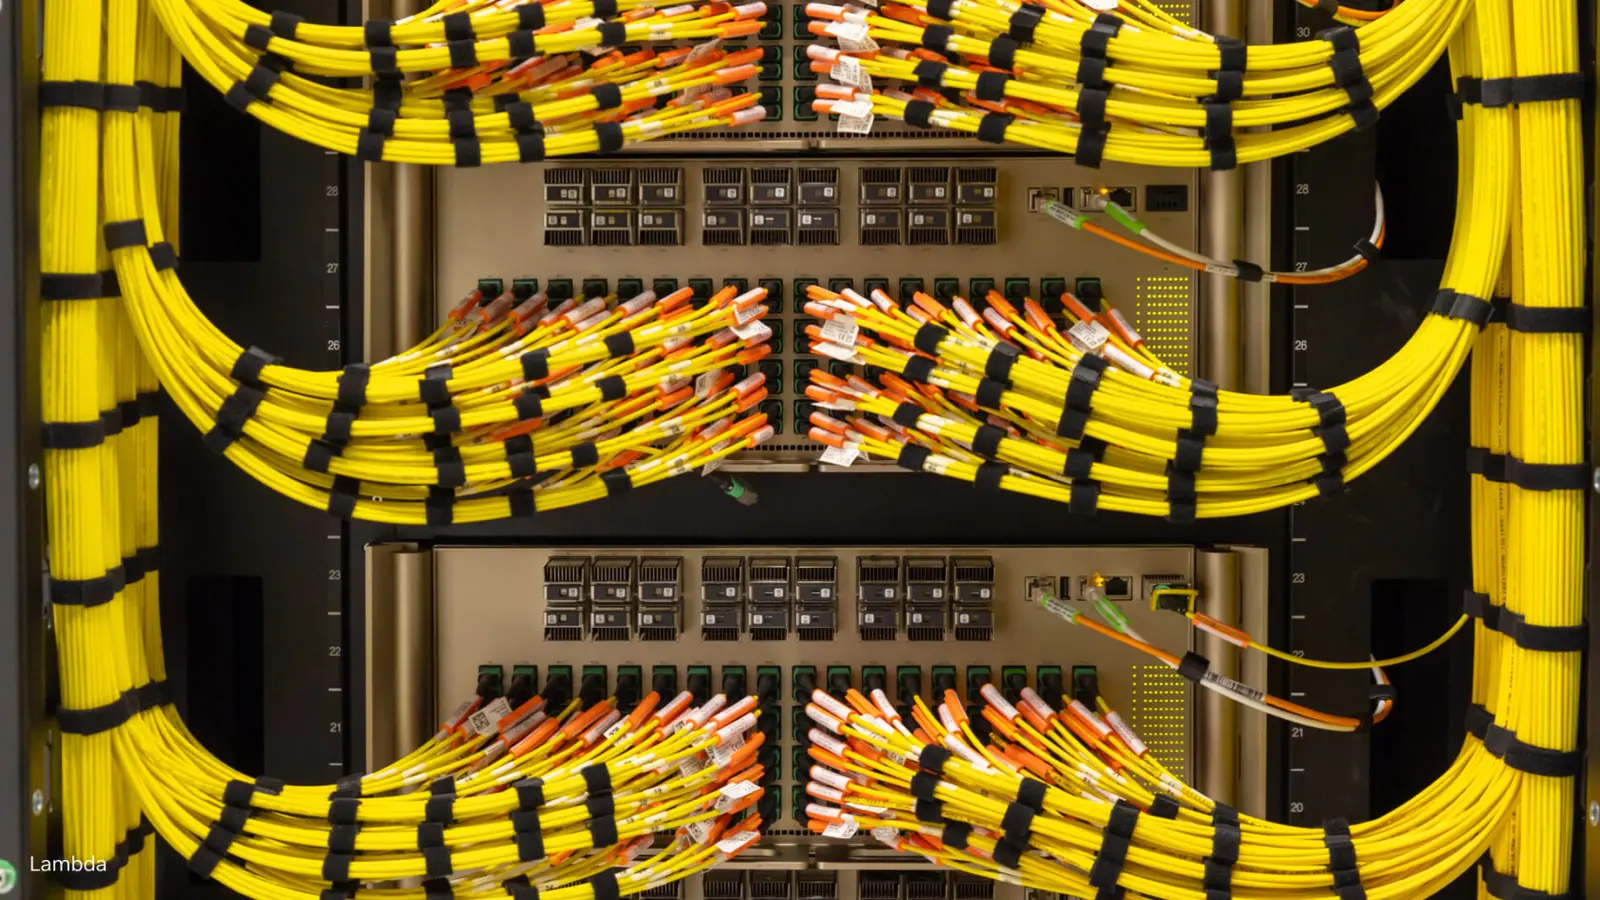
云端服务商 Lambda 正使用 NVIDIA Photonics 共封装光学(CPO)交换器,连接容纳逾 10,000 颗 GPU 的 NVIDIA GB300 NVL72 机架。NVIDIA 表示,这个设计为 AI 工厂的网络带来更低耗电、更高韧性和更长的平均无中断时间。NVIDIA 在 2026 年 11 月 16 日的 SC26 公布中发表有关详情。
网络是 AI 集群中最少人留意的部分。训练一个模型需要数以千计的 GPU 协同运作,所以它们之间的连线必须快速、高效而且稳定。NVIDIA 指出,大型训练任务中只要有一条连线中断,就可能令数千颗 GPU 停顿。
Lambda 量度到甚么?
NVIDIA 表示,Lambda 的测试显示三点:
- 网络延迟在机架规模下降约 4%,在 pod 规模下最多降约 10%。
- 在机架、可扩展单元和 pod 配置中,吞吐量与传统可插拔光学器件相同。
- Lambda 报告光学器件的中位温度为 36°C,传统可插拔光学器件则为 51°C,而且讯号完整性更稳定。
Lambda 云端服务总裁 Dave Ward 说:“网络必须跟上日益庞大的 AI 集群需求。”
交换器如何运作?
共封装不是在每个端口插入收发器,而是把光学引擎放在交换器芯片旁边,同在一个封装内。NVIDIA 表示,这样取代可插拔收发器,能达到比传统可插拔光学器件最高 5 倍的能效和最高 15 倍的可靠度,雷射数量减少为四分之一,意味着可能出故障的部件更少。
NVIDIA 就 Lambda 部署提供的细节:
- 每部交换器有 144 个端口,速率为 800Gb/s。
- 液冷系统带走交换器芯片和光学引擎的热量。
- 每部交换器有 18 个可拆卸的外置光源,雷射故障时技师可在现场更换光源模组,毋须更换整个收发器。
- 共封装把电讯号路径由数英寸缩短至数毫米,并省去重定时芯片,减少耗电及讯号路径上的部件数量。
Lambda 自己的耗电数字如何?
Lambda 在 2026 年 6 月 1 日撰文介绍一款 NVIDIA Quantum-X Photonics 交换器的工程样品 Q3450-LD。这是 4U 设备,具备 115.2 Tb/s 无阻塞交换容量,同样列明 144 个 800G 端口和 18 个可拆卸光源模组。
Lambda 列出该交换器耗电为 3.95 kW,标准交换器为 7.0 kW,即每部节省 3.05 kW。以 10,368 颗 GPU 的 GB300 NVL72 集群计,需要 216 部 CPO 交换器,释放 658 kW 网络电力,相当于多出 470 颗 GPU 的供电。
Lambda 同时提醒:CPO 不会自动增加可部署的 GPU 数量,因为机架布局、散热和供电分配才决定这些瓦数如何使用。Lambda 又指,128,000 颗 GPU 的数据中心若采用传统可插拔收发器,约需 655,000 个模组,每一个都是潜在故障点;在这个规模的三层集群中,后端网络占网络耗电的 86%。
价钱多少?
NVIDIA 和 Lambda 的文章都没有列出交换器或 Lambda GPU 容量的价格。价格和供应情况需直接向 NVIDIA 和 Lambda 查询。
适合甚么人
AI 基建及数据中心规划人员。 耗电、温度和可靠度数字最有参考价值,因为它们显示在逾 10,000 颗 GPU 的规模下,网络层以瓦数和中断计付出的代价。
租用 GPU 容量的团队。 Lambda 是云端服务商,网络中断减少对长时间任务最重要。资料来源没有说明客户的服务或价格会否改变。
营运小得多的集群的人。 这些数字来自逾 10,000 颗 GPU 的部署,不能当作少量机架的保证。
想要独立数据的人。 以上所有量度都来自 NVIDIA 或 Lambda,没有任何来源附上外部测试,百分比属厂商提供。
还有甚么未知之数?
资料来源没有指明部署地点、有多少 Lambda 客户使用该集群,也没有交换器全面供应的日期。NVIDIA 和 Lambda 亦没有公布这项部署的耗电数字。
如想了解技术细节,可阅读 NVIDIA 有关 Lambda 部署的文章,以及 Lambda 对 Quantum-X Photonics 交换器的介绍。