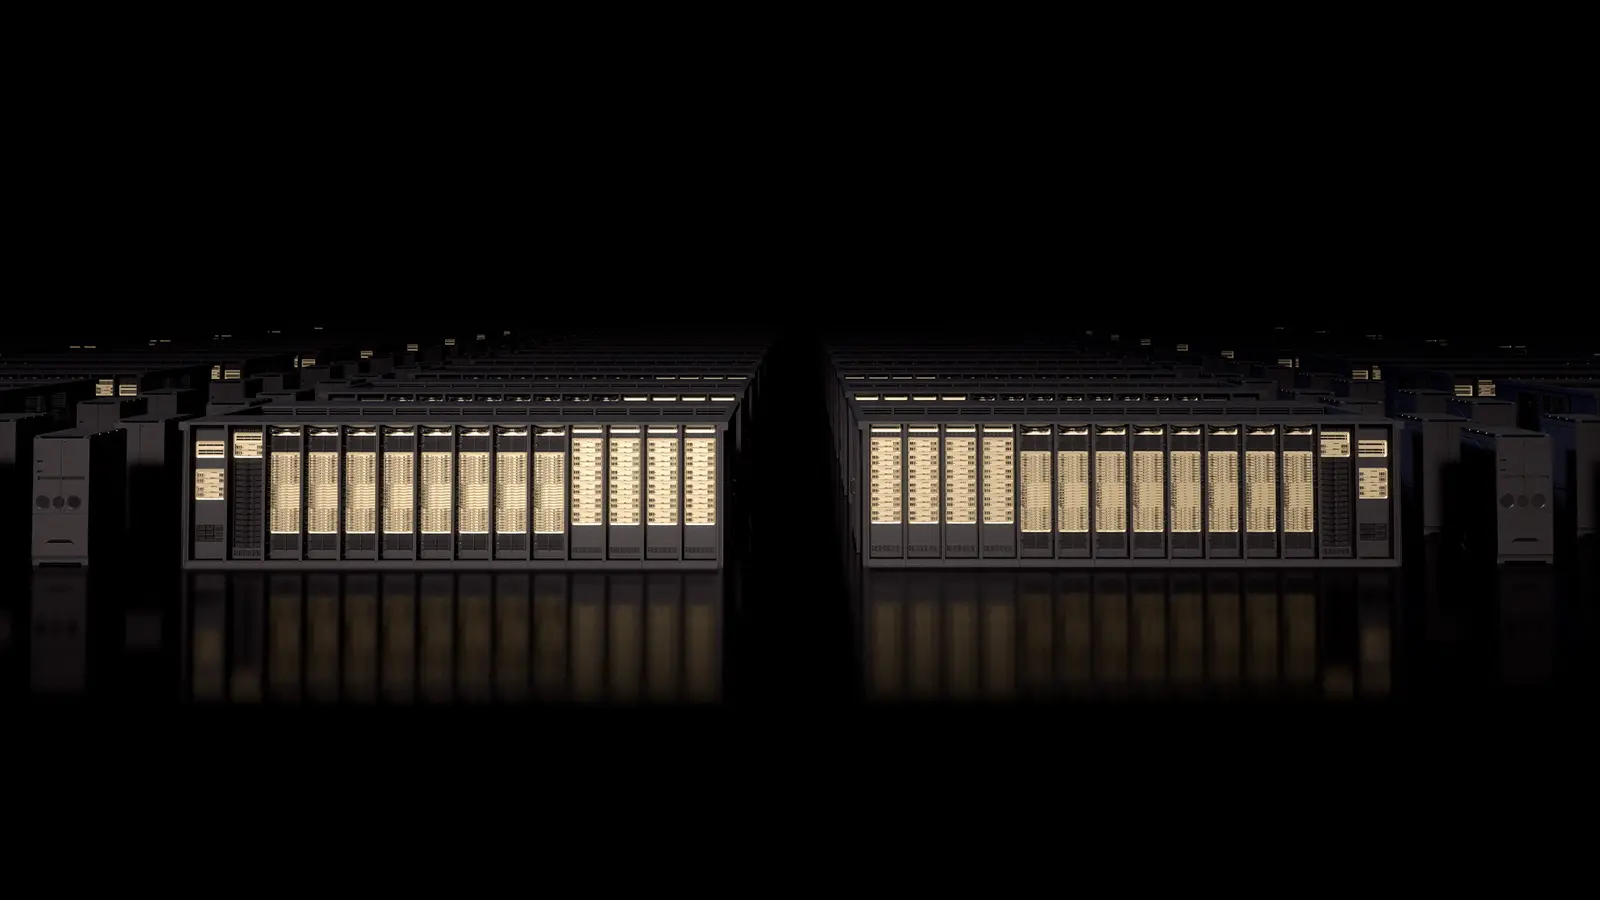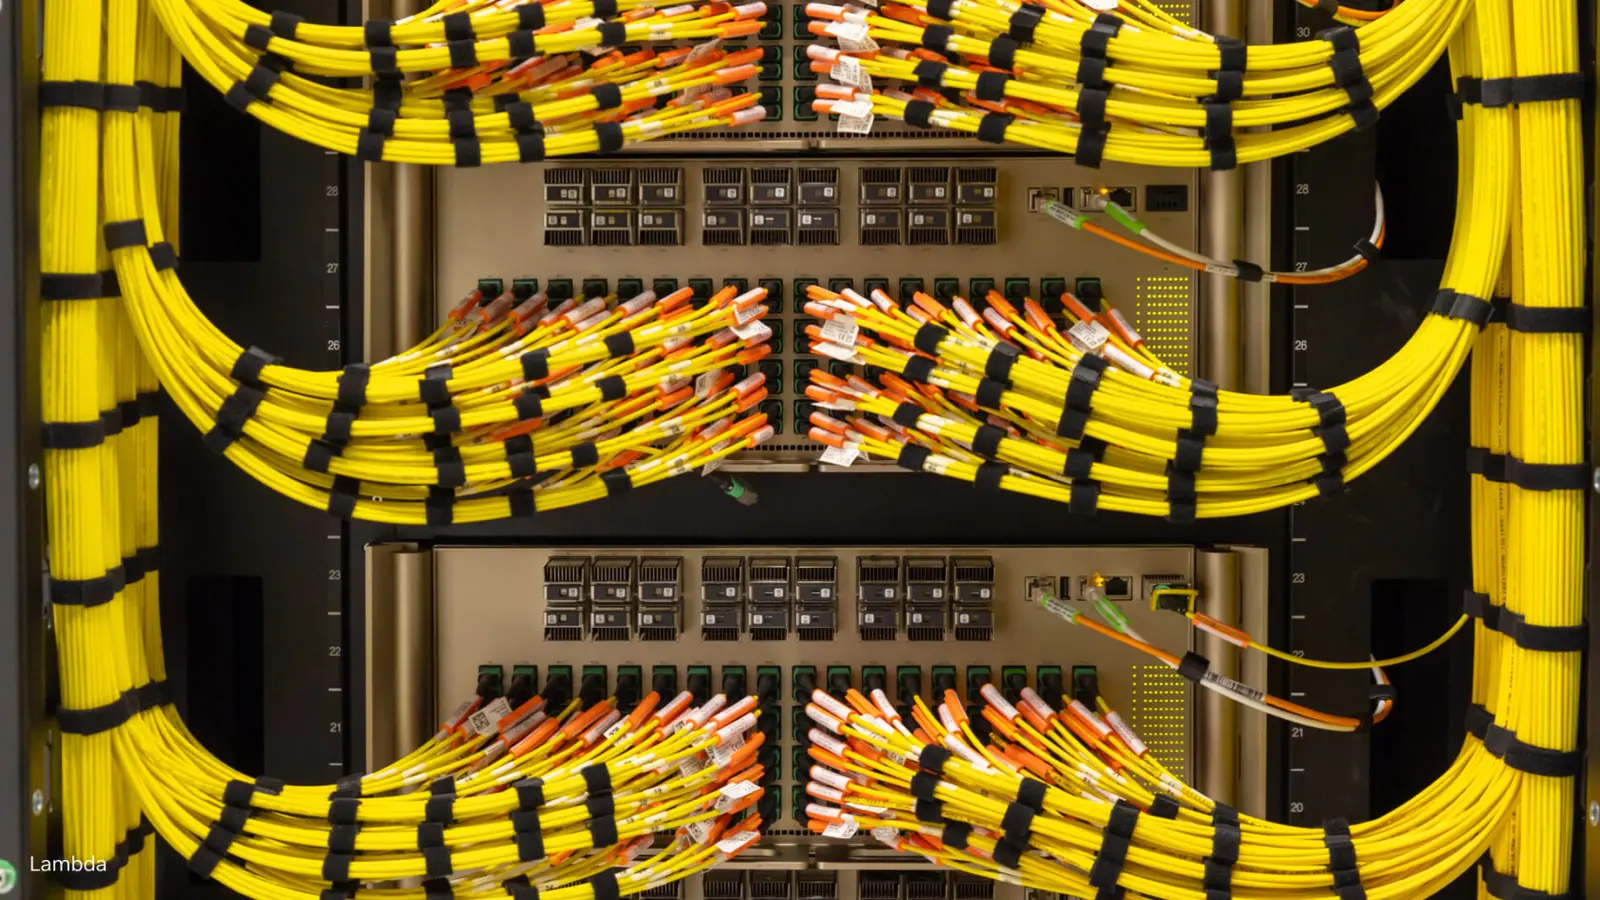
El proveedor de nube Lambda usa los conmutadores NVIDIA Photonics de óptica coempaquetada (CPO) para conectar racks NVIDIA GB300 NVL72 con más de 10,000 GPU. NVIDIA asegura que el diseño reduce el consumo de energía, mejora la resiliencia y alarga el tiempo medio entre interrupciones en la red de una fábrica de IA. NVIDIA publicó los detalles el 16 de noviembre de 2026, dentro de sus anuncios del SC26.
La red es la parte de un clúster de IA que casi nadie ve. Para entrenar un modelo, miles de GPU deben trabajar juntas, así que los enlaces entre ellas tienen que ser rápidos, eficientes y resilientes. Según NVIDIA, un solo enlace interrumpido en un entrenamiento grande puede detener a miles de GPU.
¿Qué midió Lambda?
NVIDIA indica que las pruebas de Lambda con los conmutadores mostraron tres cosas:
- La latencia de red bajó cerca de 4% a escala de rack y hasta cerca de 10% a escala de pod.
- El rendimiento se mantuvo igual que con la óptica enchufable convencional en configuraciones de rack, unidad escalable y pod.
- Lambda reporta una temperatura mediana de la óptica de 36°C, frente a 51°C en la óptica enchufable convencional, además de una integridad de señal más estable.
Dave Ward, presidente de servicios en la nube de Lambda, dijo: «La red tiene que estar a la altura de las exigencias de clústeres de IA cada vez más grandes».
¿Cómo funcionan los conmutadores?
En lugar de enchufar un transceptor en cada puerto, la coempaquetación coloca los motores ópticos junto al chip del conmutador, en el mismo paquete. NVIDIA afirma que este reemplazo ofrece hasta 5x más eficiencia energética y hasta 15x más fiabilidad que la óptica enchufable convencional, y que usa 4x menos láseres, es decir, menos piezas que pueden fallar.
Los detalles que NVIDIA da sobre el despliegue de Lambda:
- Cada conmutador tiene 144 puertos que funcionan a 800Gb/s.
- Un sistema de refrigeración líquida retira el calor del chip y de los motores ópticos.
- Cada conmutador tiene 18 fuentes de luz externas extraíbles, que los técnicos pueden cambiar en campo en lugar de sustituir todo el módulo cuando falla un láser.
- La coempaquetación acorta el camino eléctrico de pulgadas a milímetros y elimina los chips retemporizadores, lo que reduce el consumo y la cantidad de piezas en la ruta de la señal.
¿Qué dicen las cifras de Lambda sobre energía?
Lambda escribió el 1 de junio de 2026 sobre una muestra de ingeniería de un conmutador NVIDIA Quantum-X Photonics, el Q3450-LD: una unidad 4U con 115.2 Tb/s de capacidad sin bloqueo, que lista los mismos 144 puertos de 800G y 18 módulos de fuente de luz extraíbles.
Lambda indica un consumo de 3.95 kW, frente a 7.0 kW de un conmutador estándar, un ahorro de 3.05 kW por conmutador. Para un clúster GB300 NVL72 de 10,368 GPU contó 216 conmutadores CPO y 658 kW de energía de red liberada, el equivalente a 470 GPU adicionales.
Lambda añade una advertencia: el CPO no aumenta automáticamente la cantidad de GPU desplegables, porque la disposición de los racks, la refrigeración y la distribución eléctrica determinan cómo se usan esos vatios. También señala que un centro de datos de 128,000 GPU con transceptores enchufables tradicionales necesita unos 655,000 módulos, cada uno un posible punto de falla, y que la red de back-end representa 86% de la energía de red en un clúster de tres capas a esta escala.
¿Cuánto cuesta?
Ni la publicación de NVIDIA ni la de Lambda indican un precio para los conmutadores ni para la capacidad de GPU de Lambda. El precio y la disponibilidad hay que consultarlos directamente con NVIDIA y Lambda.
A quién le conviene
A planificadores de infraestructura de IA y de centros de datos. Las cifras de energía, temperatura y fiabilidad son lo útil: muestran lo que cuesta la capa de red en vatios y en interrupciones con más de 10,000 GPU.
A equipos que alquilan capacidad de GPU. Lambda es un proveedor de nube, y menos interrupciones de red importan sobre todo en trabajos largos. Las fuentes no dicen si los clientes verán cambios en el servicio o el precio.
A operadores de clústeres mucho más pequeños. Las cifras vienen de un despliegue de más de 10,000 GPU y no son una promesa para unos pocos racks.
A quienes quieren mediciones independientes. Todas las mediciones provienen de NVIDIA o de Lambda. Ninguna fuente incluye una prueba externa, así que los porcentajes son datos de los fabricantes.
¿Qué falta por saber?
Las fuentes no nombran el sitio, no dicen cuántos clientes de Lambda usan el clúster ni dan una fecha de disponibilidad general de los conmutadores. Tampoco publican una cifra de consumo para este despliegue concreto.
Para el detalle técnico, lee la publicación de NVIDIA sobre el despliegue de Lambda y el texto de Lambda sobre el conmutador Quantum-X Photonics.