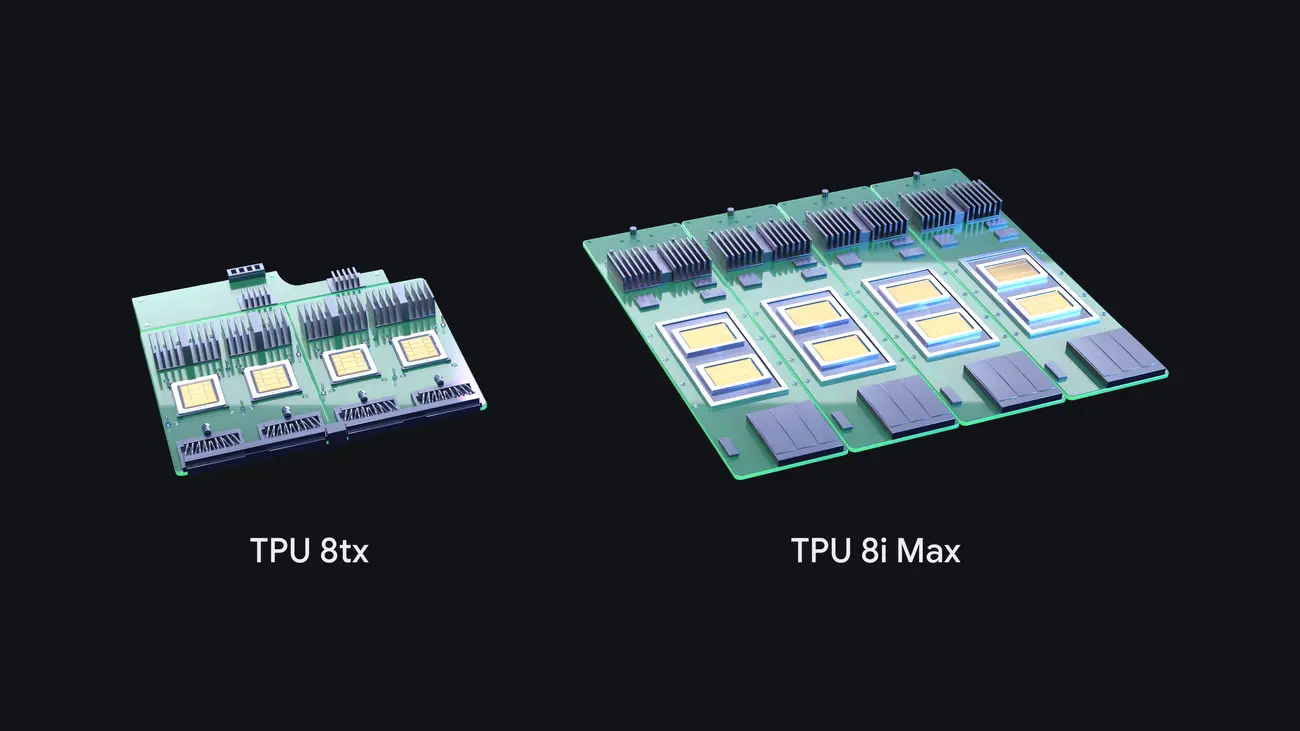
Google 为第八代 TPU 系列新增两个系统:专为安全及保密推理而设的 TPU 8tx,以及针对超大上下文窗口的 TPU 8i Max。公司于 11 月 9 日公布,并表示这是首次在一年内推出四个 TPU 系统。
TPU 是 Google 为 AI 工作自行设计的处理器。它不是在商店买到的电子产品,大部分读者只会通过云端服务及相关应用间接接触,但它仍然左右这些服务的速度、隐私程度及成本。
这一代的四个系统是甚么?
Google 于 4 月的 Google Cloud Next 首次介绍 TPU 8t 与 TPU 8i,新增两款则是建基于同一基础的变体。
- TPU 8t:训练大型基础模型
- TPU 8i:低延迟实时推理
- TPU 8tx:安全及保密推理,亦适合小规模训练
- TPU 8i Max:超大上下文窗口,以及每个机架最高的运算密度
对于前两款,Google 称与上一代相比,8t 的训练效能最多提升 2.7 倍,8i 的推理性价比提升 80%。公司亦指 8i 可将芯片之间的通讯延迟最多减少一半。
TPU 8tx 有甚么用途?
TPU 8tx 针对受监管企业及政府,这些机构需要用前沿或自家专有模型处理敏感资料。
- 与 TPU 8t 采用相同的矽芯片
- 搭配第 5 代 AMD EPYC CPU 主机
- 采用最初为 TPU 8i 开发的低延迟 Boardfly 网络
- 据 Google 表示,延迟最多比 TPU 8t 低 2x,而效能损失接近零
资料平时在储存及网络传输时会加密,但电脑处理时必须在内存中解密。Google 表示 8tx 把保护直接做进硬件,令敏感资料及模型权重即使在使用中也保持隔离。由于它结合训练级运算与高速网络,同一个系统可以同时运行及调校模型。
TPU 8i Max 有甚么用途?
TPU 8i Max 把两颗 TPU 8i 芯片整合在同一封装内。
- 运算能力为 TPU 8i 的两倍
- SRAM 为两倍
- HBM 频宽为两倍
- 可放入现有机架的空间
Google 的理据是:当大量软件代理程序处理整个程序码库或长达数小时的视频时,内存频宽会成为瓶颈。公司表示,在同一机架空间内放入两倍的矽芯片,数据中心每平方呎及每瓦特可获得更多运算力。
开发者现在更容易使用 TPU 吗?
Google 表示一直在拆除使用门槛。上月公司开源了 TorchTPU,令 PyTorch 程序码及 Hugging Face 模型可在 TPU 上原生运行,并支持 vLLM 及 SGLang 推理引擎。处于预览阶段的开源 TPU 代理套件,可连接 Cursor 等编程工具,协助上手及调校。Google 亦开源了 TPU Sync,称可将 KV 传输延迟及首个词元时间减少逾 90%,并公布 Agent Compute Engine,可暂停闲置的代理程序工作阶段以节省成本。TPU 目前有近 100 个客户,包括前沿实验室、交易公司、零售商及大学。
价格
Google 没有公布 TPU 8tx 或 TPU 8i Max 的价格及推出日期。TPU 以云端算力形式销售,客户亦可部署在自己的数据中心,因此没有零售价。至于 8t 与 8i,TechRadar 报道 Google Cloud 客户预计在未来数月开始可以使用。
适合哪些人
受监管机构。银行、医疗机构及公共部门需要在模型处理资料时保持资料受保护,是 TPU 8tx 的目标对象。
处理长上下文的团队。在大型程序码库或长视频上运行大量代理程序的企业,是 TPU 8i Max 的使用场景。
PyTorch 开发者。据 Google 表示,有了 TorchTPU,现有程序码及 Hugging Face 模型无需改写即可在 TPU 上运行。
一般读者。你不会自己购买这些芯片,但它们可能支撑你使用的云端工具,更快、更保密的后端日后或会带来更好的服务。
还有哪些未知数?
Google 没有提供两款新系统的推出日期、地区供应或价格,亦没有公布与竞争对手硬件比较的测试数字。相关细节可留意 Google Cloud 的基础设施页面。