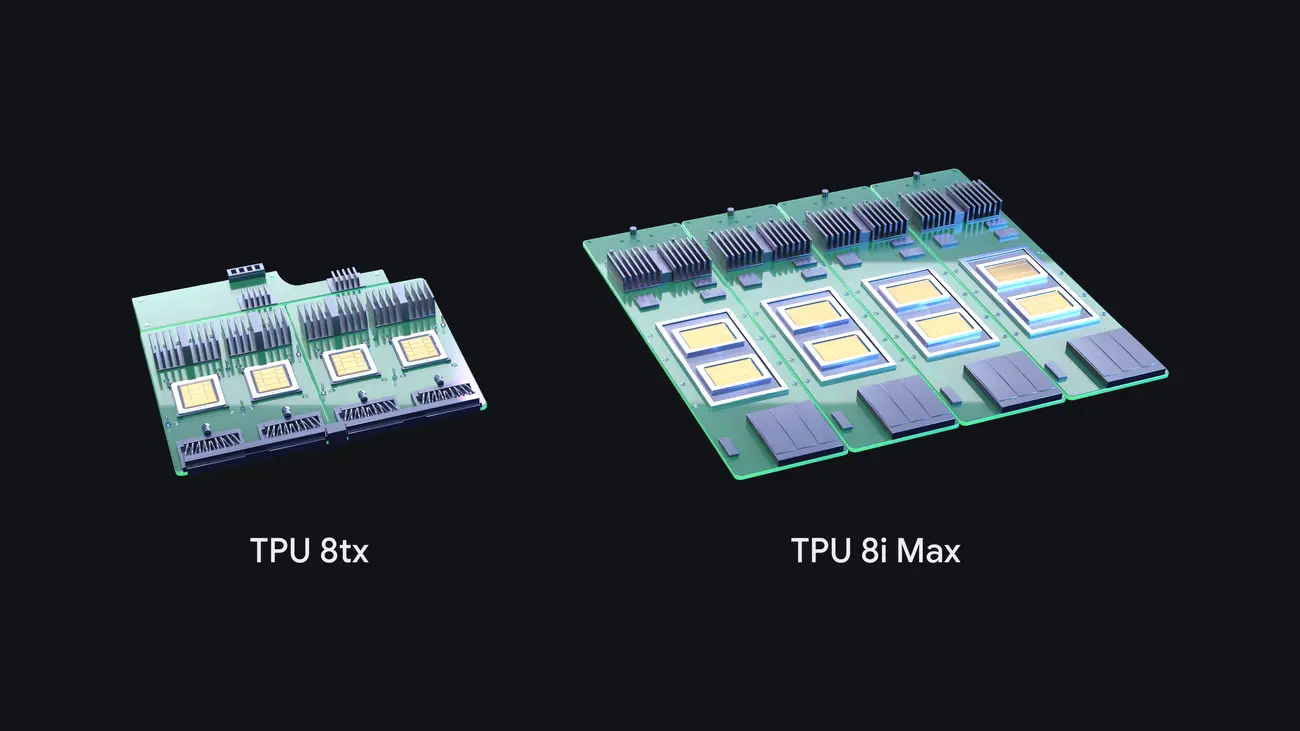
Google 為第八代 TPU 系列新增兩個系統:專為安全及保密推理而設的 TPU 8tx,以及針對超大上下文視窗的 TPU 8i Max。公司於 11 月 9 日公佈,並表示這是首次在一年內推出四個 TPU 系統。
TPU 是 Google 為 AI 工作自行設計的處理器。它不是在商店買到的電子產品,大部分讀者只會透過雲端服務及相關應用間接接觸,但它仍然左右這些服務的速度、私隱程度及成本。
這一代的四個系統是甚麼?
Google 於 4 月的 Google Cloud Next 首次介紹 TPU 8t 與 TPU 8i,新增兩款則是建基於同一基礎的變體。
- TPU 8t:訓練大型基礎模型
- TPU 8i:低延遲即時推理
- TPU 8tx:安全及保密推理,亦適合小規模訓練
- TPU 8i Max:超大上下文視窗,以及每個機架最高的運算密度
對於前兩款,Google 稱與上一代相比,8t 的訓練效能最多提升 2.7 倍,8i 的推理性價比提升 80%。公司亦指 8i 可將晶片之間的通訊延遲最多減少一半。
TPU 8tx 有甚麼用途?
TPU 8tx 針對受監管企業及政府,這些機構需要用前沿或自家專有模型處理敏感資料。
- 與 TPU 8t 採用相同的矽晶片
- 搭配第 5 代 AMD EPYC CPU 主機
- 採用最初為 TPU 8i 開發的低延遲 Boardfly 網絡
- 據 Google 表示,延遲最多比 TPU 8t 低 2x,而效能損失接近零
資料平時在儲存及網絡傳輸時會加密,但電腦處理時必須在記憶體中解密。Google 表示 8tx 把保護直接做進硬件,令敏感資料及模型權重即使在使用中也保持隔離。由於它結合訓練級運算與高速網絡,同一個系統可以同時運行及調校模型。
TPU 8i Max 有甚麼用途?
TPU 8i Max 把兩顆 TPU 8i 晶片整合在同一封裝內。
- 運算能力為 TPU 8i 的兩倍
- SRAM 為兩倍
- HBM 頻寬為兩倍
- 可放入現有機架的空間
Google 的理據是:當大量軟件代理程式處理整個程式碼庫或長達數小時的影片時,記憶體頻寬會成為瓶頸。公司表示,在同一機架空間內放入兩倍的矽晶片,數據中心每平方呎及每瓦特可獲得更多運算力。
開發者現在更容易使用 TPU 嗎?
Google 表示一直在拆除使用門檻。上月公司開源了 TorchTPU,令 PyTorch 程式碼及 Hugging Face 模型可在 TPU 上原生運行,並支援 vLLM 及 SGLang 推理引擎。處於預覽階段的開源 TPU 代理套件,可連接 Cursor 等編程工具,協助上手及調校。Google 亦開源了 TPU Sync,稱可將 KV 傳輸延遲及首個詞元時間減少逾 90%,並公佈 Agent Compute Engine,可暫停閒置的代理程式工作階段以節省成本。TPU 目前有近 100 個客戶,包括前沿實驗室、交易公司、零售商及大學。
價格
Google 沒有公佈 TPU 8tx 或 TPU 8i Max 的價格及推出日期。TPU 以雲端算力形式銷售,客戶亦可部署在自己的數據中心,因此沒有零售價。至於 8t 與 8i,TechRadar 報道 Google Cloud 客戶預計在未來數月開始可以使用。
適合哪些人
受監管機構。銀行、醫療機構及公共部門需要在模型處理資料時保持資料受保護,是 TPU 8tx 的目標對象。
處理長上下文的團隊。在大型程式碼庫或長影片上運行大量代理程式的企業,是 TPU 8i Max 的使用場景。
PyTorch 開發者。據 Google 表示,有了 TorchTPU,現有程式碼及 Hugging Face 模型無需改寫即可在 TPU 上運行。
一般讀者。你不會自己購買這些晶片,但它們可能支撐你使用的雲端工具,更快、更保密的後端日後或會帶來更好的服務。
還有哪些未知數?
Google 沒有提供兩款新系統的推出日期、地區供應或價格,亦沒有公佈與競爭對手硬件比較的測試數字。相關細節可留意 Google Cloud 的基礎設施頁面。